Présentation
Lenexux est une plateforme d’intelligence des dépendances et d’impact. Elle cartographie systèmes, fournisseurs et personnes clés d’une organisation en un graphe vivant, révèle les points uniques de défaillance, simule des incidents et chiffre leur impact — au-delà des frontières des outils (ERP, ITSM, CRM).
Positionnement : une couche au-dessus des systèmes existants (pas un remplaçant de SAP), qui répond à des questions d’impact transversales que chaque outil, cantonné à son silo, ne voit que partiellement. Tous les chiffres sont déterministes et traçables ; l’IA sert à résoudre, reformuler et proposer — jamais à inventer les chiffres.
Concepts clés
- • Entité : un élément du graphe (serveur, application, fournisseur, personne, processus…).
- • Dépendance (relation) : « A dépend de B ». La panne de B remonte vers ses dépendants A.
- • Criticité (0, 100) : importance d’une entité ; alimente l’impact et le coût d’arrêt.
- • Confiance (0, 1) : degré de certitude d’une relation (source, IA suggérée, validée).
- • Impact direct vs indirect : direct = dépend immédiatement de la cible (profondeur 1) ; indirect = touché par la cascade (profondeur ≥ 2).
- • SPOF : point unique de défaillance, entité sans redondance dont dépendent beaucoup d’autres.
- • Propagation de compromission : en cyberattaque, un attaquant se déplace le long des relations d’accès et de données (latéralement), distincte de la propagation de panne.
- • Dépendance IA : un modèle, agent ou fournisseur d’IA est une dépendance comme une autre, sa défaillance se propage et se chiffre par le même moteur.
- • Tenant : espace client isolé. Chaque organisation a ses données, invisibles des autres.
Ontologie (vocabulaire contrôlé)
Lenexux normalise toutes les données vers une ontologie propriétaire, ce qui permet de relier des sources hétérogènes. Types d’entités par catégorie :
Types de relations : DEPENDS_ON, RUNS_ON, HOSTS, USES, SUPPLIED_BY, AUTHENTICATES, MAINTAINS, CONNECTS_TO, STORES, PROTECTS, PART_OF, LOCATED_IN. La résolution est tolérante (synonymes, casse), avec repli sûr.
Prise en main
- • Démo : page d’accueil → « Explorer la démo » → choisir un jeu (CGI ou Bell Telecom). Espaces complets et indépendants.
- • Compte : « Se connecter ». Chaque inscription crée un espace de travail vide (à alimenter via « Import & intégration »).
- • Étapes typiques : importer/inférer les dépendances → explorer le graphe → analyser risques & impact → simuler → planifier les actions.
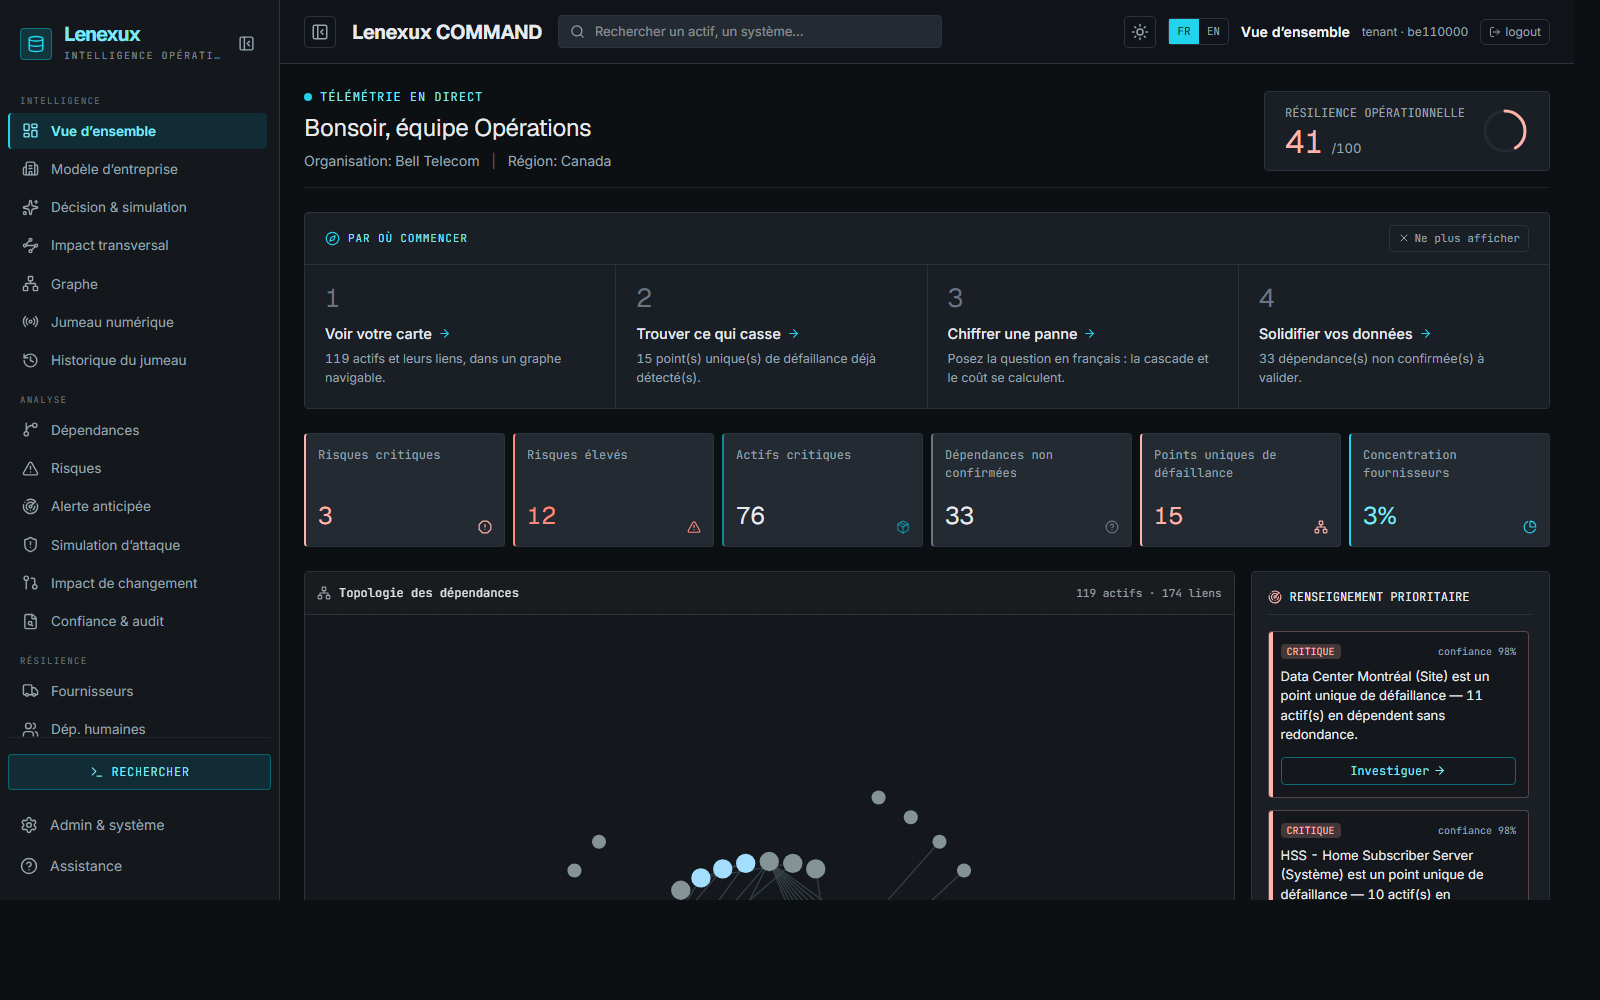
Vue d’ensemble
Le tableau de bord synthétise l’état de l’organisation : actifs, relations, risques majeurs et fragilités. Point d’entrée vers chaque centre d’analyse.
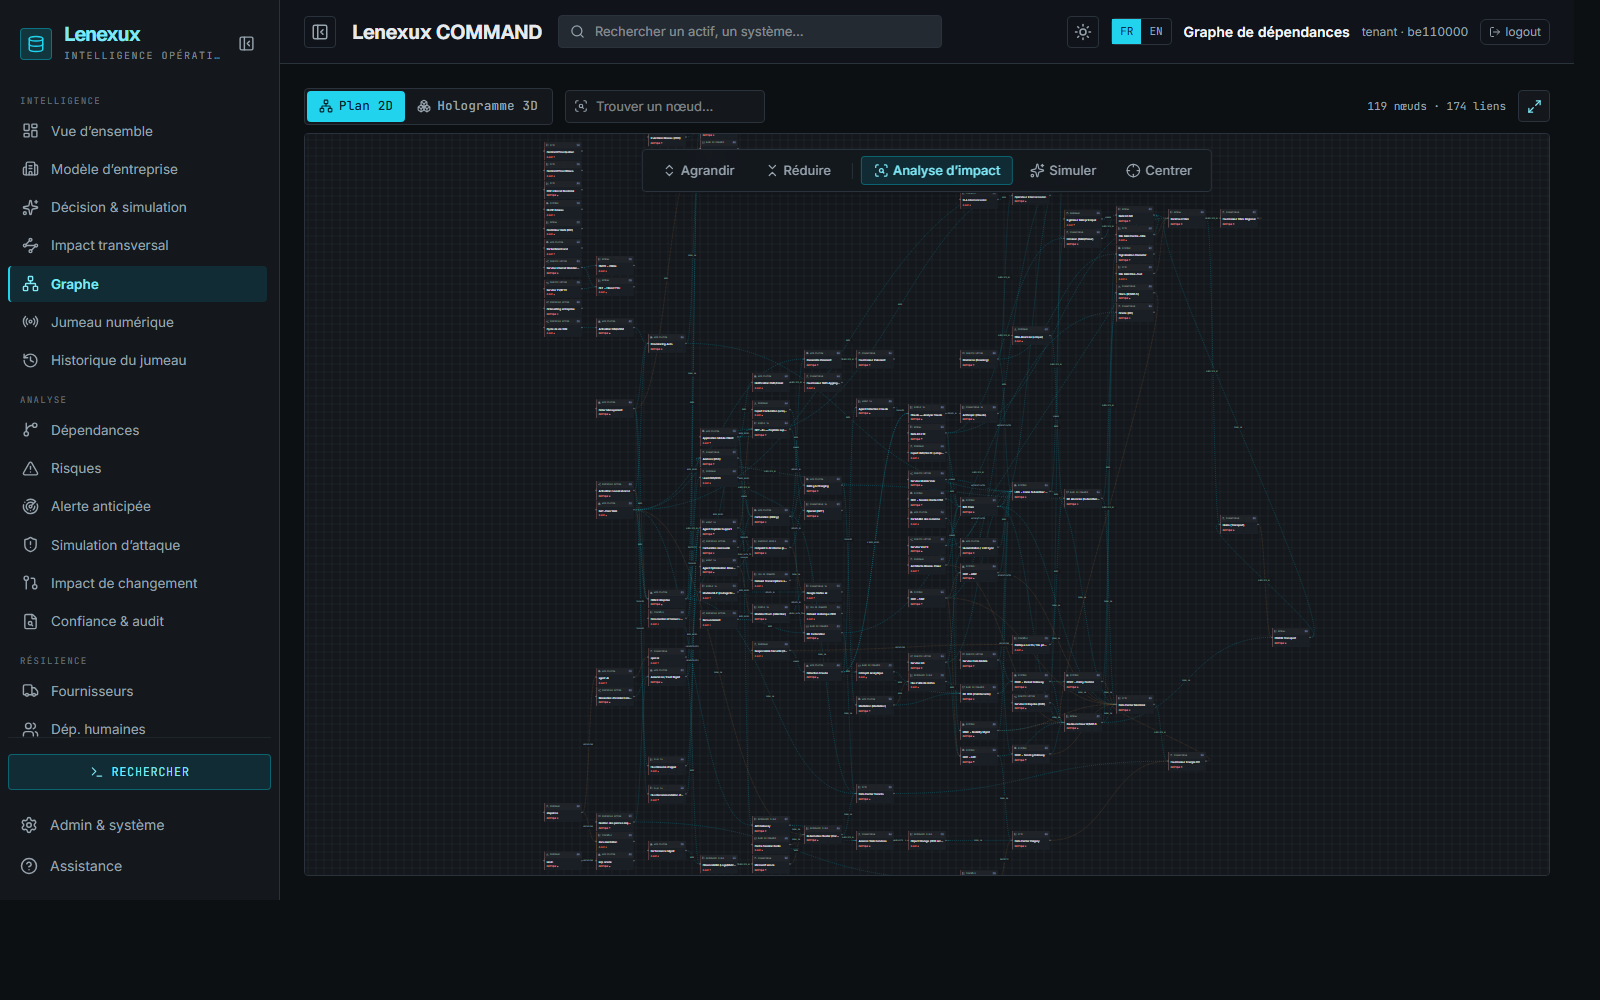
Graphe de dépendances
Deux vues : un plan 2D (ReactFlow) pour la lecture structurée et un hologramme 3D (Three.js) pour l’exploration. Sélectionner un élément met en avant ses relations et atténue le reste ; recherche, plein écran, déplacement des nœuds, clic pour les détails.
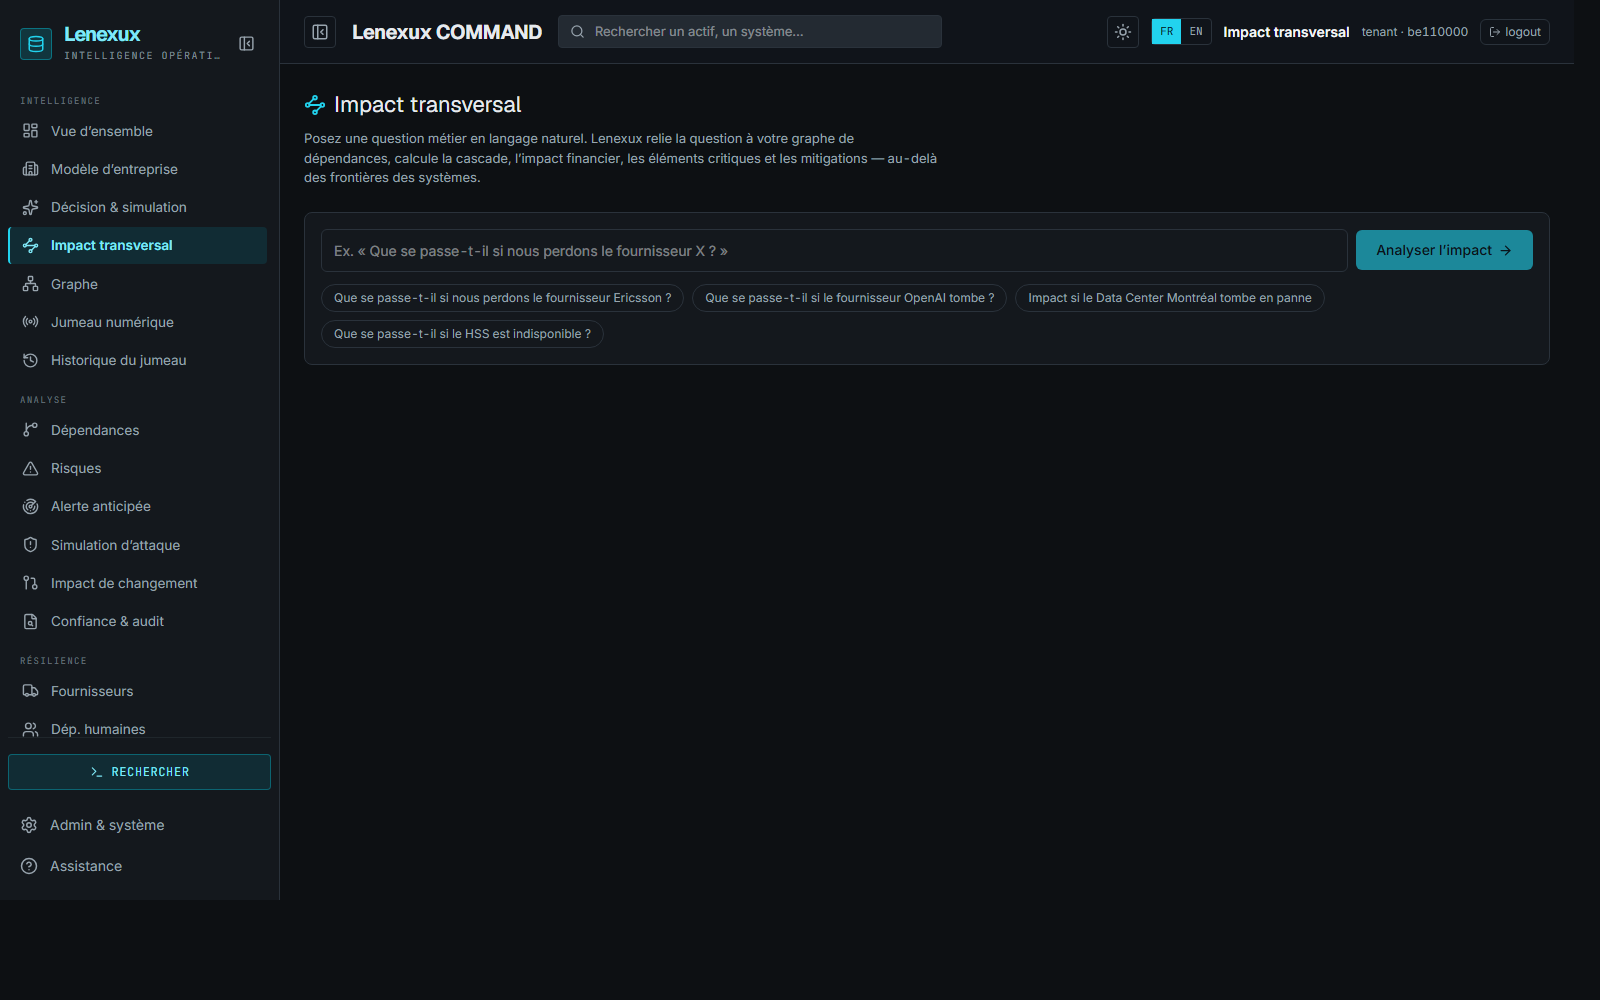
Impact transversal
Posez une question métier en langage naturel — « que se passe-t-il si nous perdons le fournisseur X ? ». Lenexux résout la cible dans le graphe, calcule la cascade, l’impact financier (pondéré par la probabilité), les éléments critiques et les points uniques de défaillance, puis propose des mitigations.
Simulation holographique (« ET SI ? »)
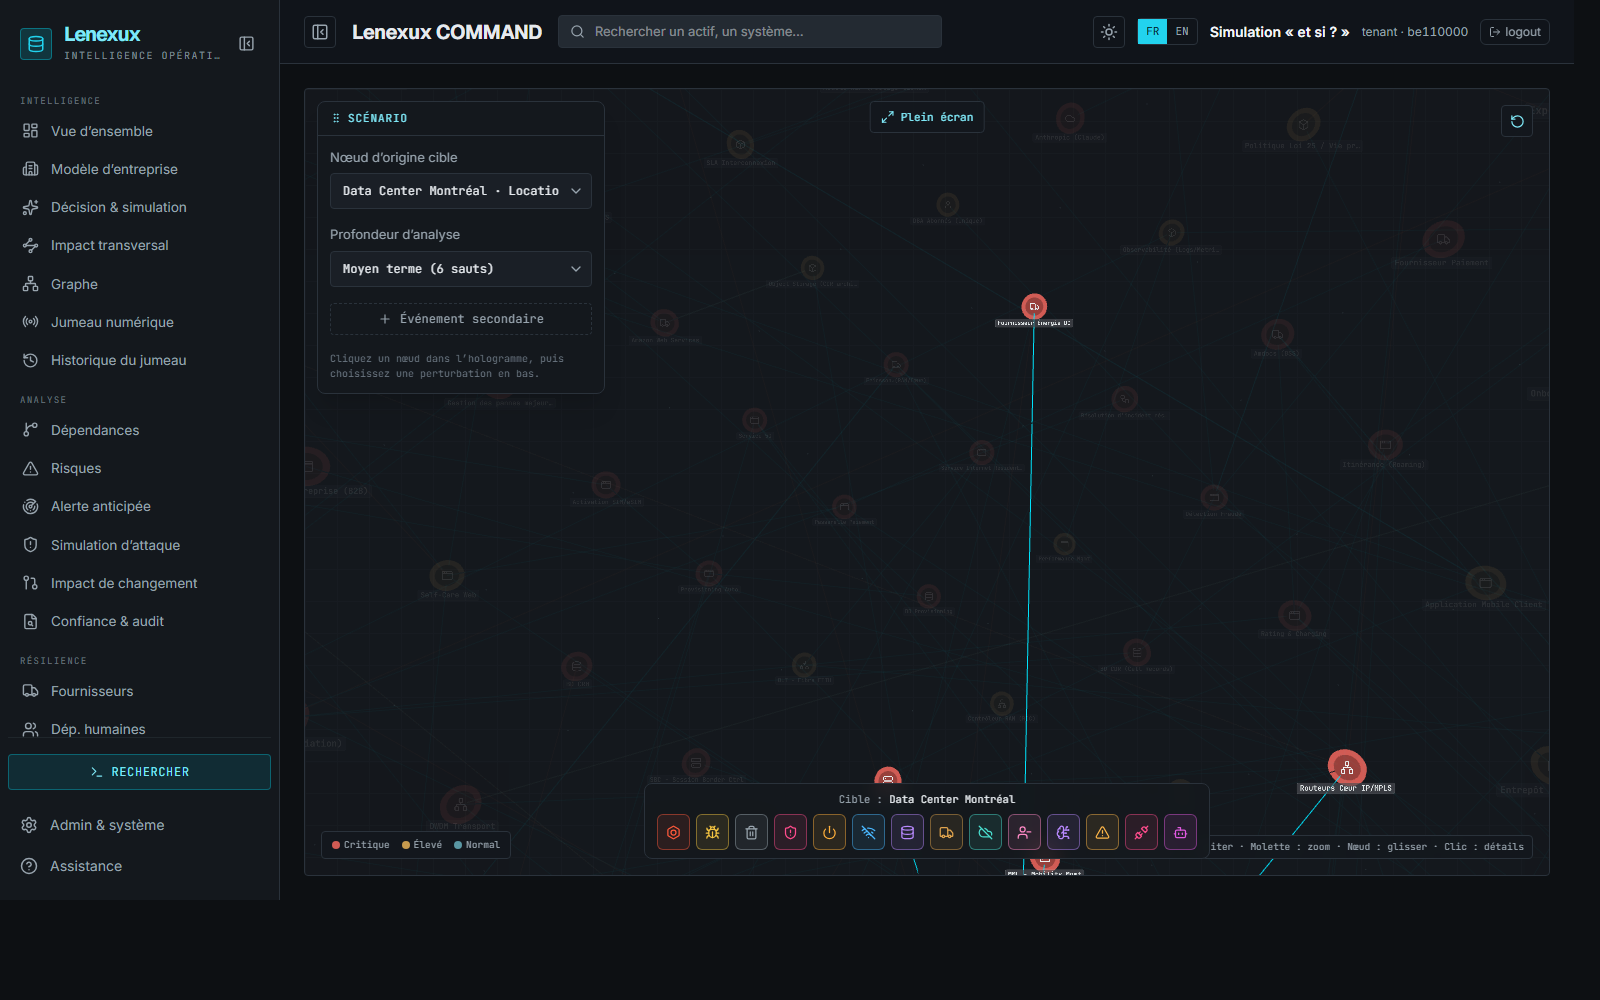
L’hologramme complet est vivant : on clique un nœud puis on applique l’une des 10 perturbations (panne, erreur logicielle, suppression, cyberattaque, panne électrique, coupure réseau, perte de données, défaillance fournisseur, panne région cloud, perte d’employé clé). La cascade se propage en animation, distinguant liens directs (vifs) et indirects (atténués).
Chaque incident a un impact logique et différent (une coupure réseau n’affecte pas un contrat ; une perte d’employé n’éteint pas un serveur). Le panneau « Impact par élément » est déplaçable et détaille chaque élément (direct/indirect, coût/h, RTO, probabilité), avec une analyse IA (risques + mitigations). Mode plein écran complet.
Simulation de cyberattaque (kill-chain)
Au-delà de la panne, Lenexux rejoue une attaque qui se propage d’un élément à l’autre. On choisit un point d’entrée (employé, outil externe, partage cloud, agent IA…) et un sens de propagation ; le moteur suit les relations d’accès et de données pour révéler la chaîne de compromission — pas seulement les liens visibles, mais le cheminement logique d’un attaquant.
Quatre scénarios prêts à l’emploi (ex. « un partage cloud est piraté et les agents IA qui en tirent leurs données se mettent à exfiltrer », « un agent IA effectue un piratage interne parti d’un employé ayant utilisé un outil externe ») et un constructeur libre bilingue (libellés lisibles, pas des codes bruts). Pour chaque nœud compromis : l’impact financier (€), la probabilité, une recommandation ciblée, et le gain d’une isolation (contre-mesure). Une analyse IA narre la kill-chain, les risques et les contre-mesures.
Dépendances IA (modèles, agents, fournisseurs)
L’IA opérationnelle est devenue une dépendance à part entière. Lenexux modélise modèles, agents, workflows, points d’accès, jeux de données et fournisseurs IA (OpenAI, Anthropic…) comme des entités de première classe, reliées au reste du graphe. Le même moteur de propagation, indépendant du type, chiffre donc l’impact d’une défaillance IA sans aucune adaptation.
- • « OpenAI tombe » → tous les agents et services qui en dépendent, l’impact financier et le RTO.
- • « Un modèle est indisponible » → les workflows métier touchés en cascade.
- • Une donnée d’entraînement compromise → les agents qui la consomment (cf. simulation de cyberattaque).
Les RTO par type d’élément IA sont alignés sur le moteur d’impact (modèle/service/point d’accès, agent/workflow, fournisseur, jeu de données), pour un chiffrage cohérent avec le reste de la plateforme.
Modèle d’entreprise (jumeau décisionnel)
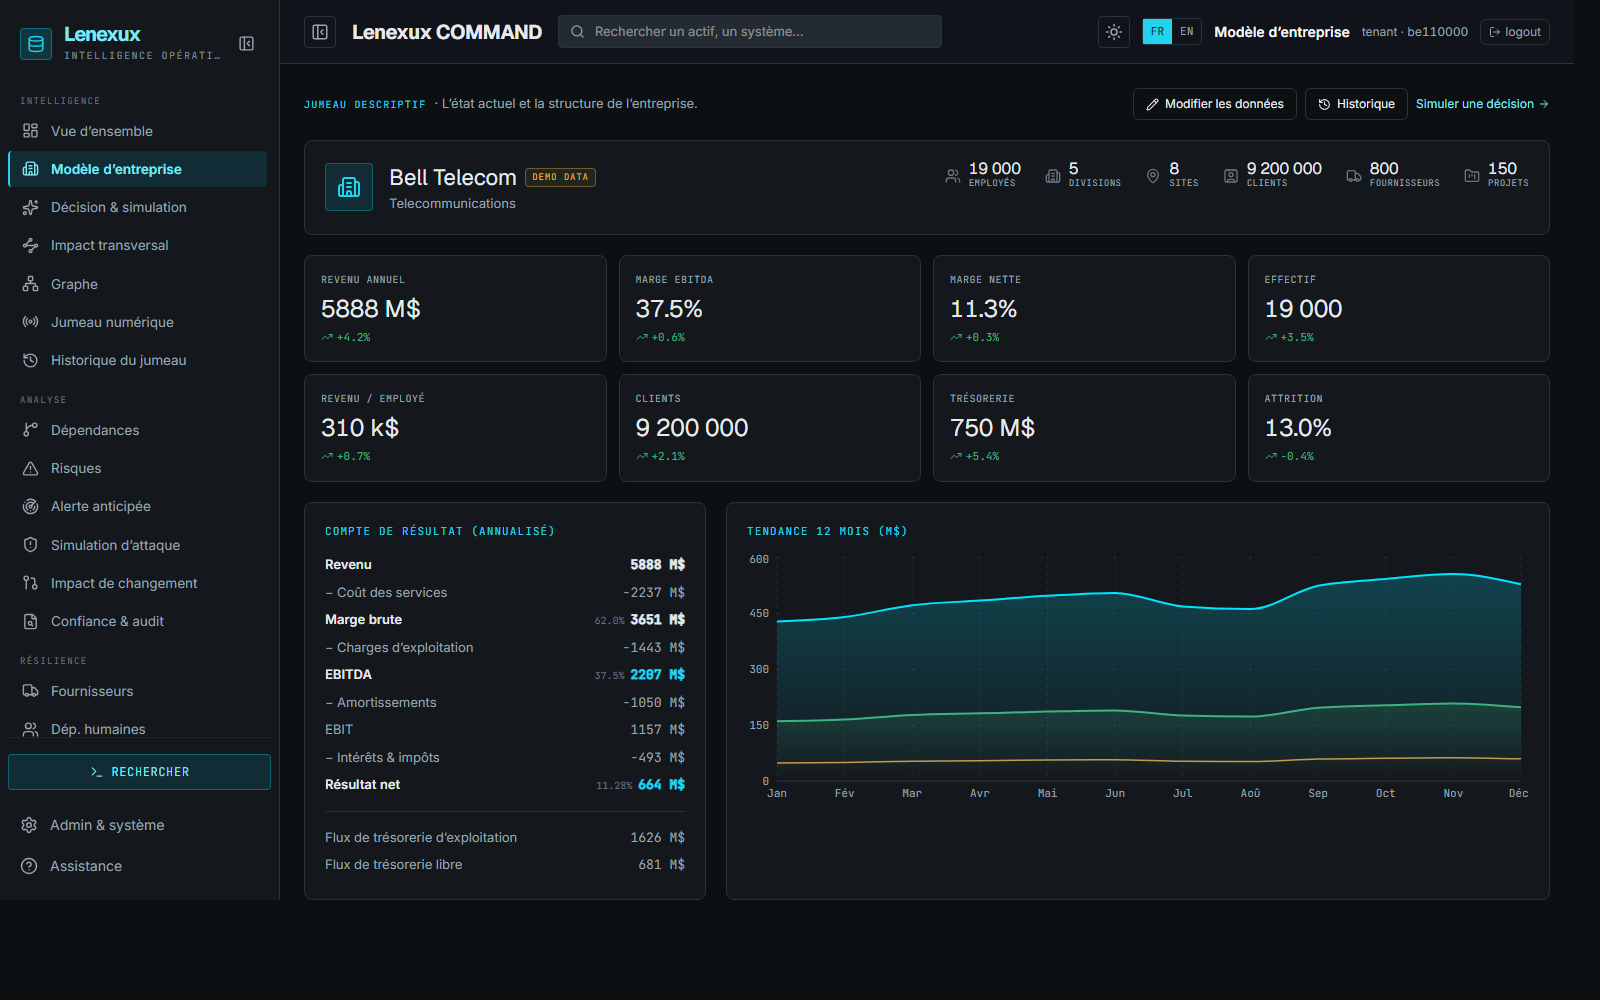
Un jumeau financier dérivé de leviers déterministes (clients/abonnés, prix, coûts, effectif, marketing, R&D, trésorerie…). S’il n’existe pas, un assistant guidé le crée ; le compte de résultat, la trésorerie et les KPIs sont ensuite calculés automatiquement.
- • Édition libre : le bouton « Modifier les données » ouvre tous les leviers (finances) et la « Structure de l’organisation » (divisions, sites, fournisseurs, projets), tout l’en-tête est modifiable.
- • Sauvegarde & historique : chaque enregistrement crée une version datée (note optionnelle) ; le panneau « Historique » liste les versions et permet de restaurer l’une d’elles en un clic (la restauration crée elle-même une version).
- • Ratios & santé financière : marge brute / EBITDA / nette, marketing/revenu, R&D/revenu, autonomie de trésorerie, revenu/employé, attrition, avec code couleur de santé.
- • « Où va chaque dollar de revenu » : ventilation lisible des coûts (livraison, salaires, R&D, marketing, amortissements).
Décision & simulation
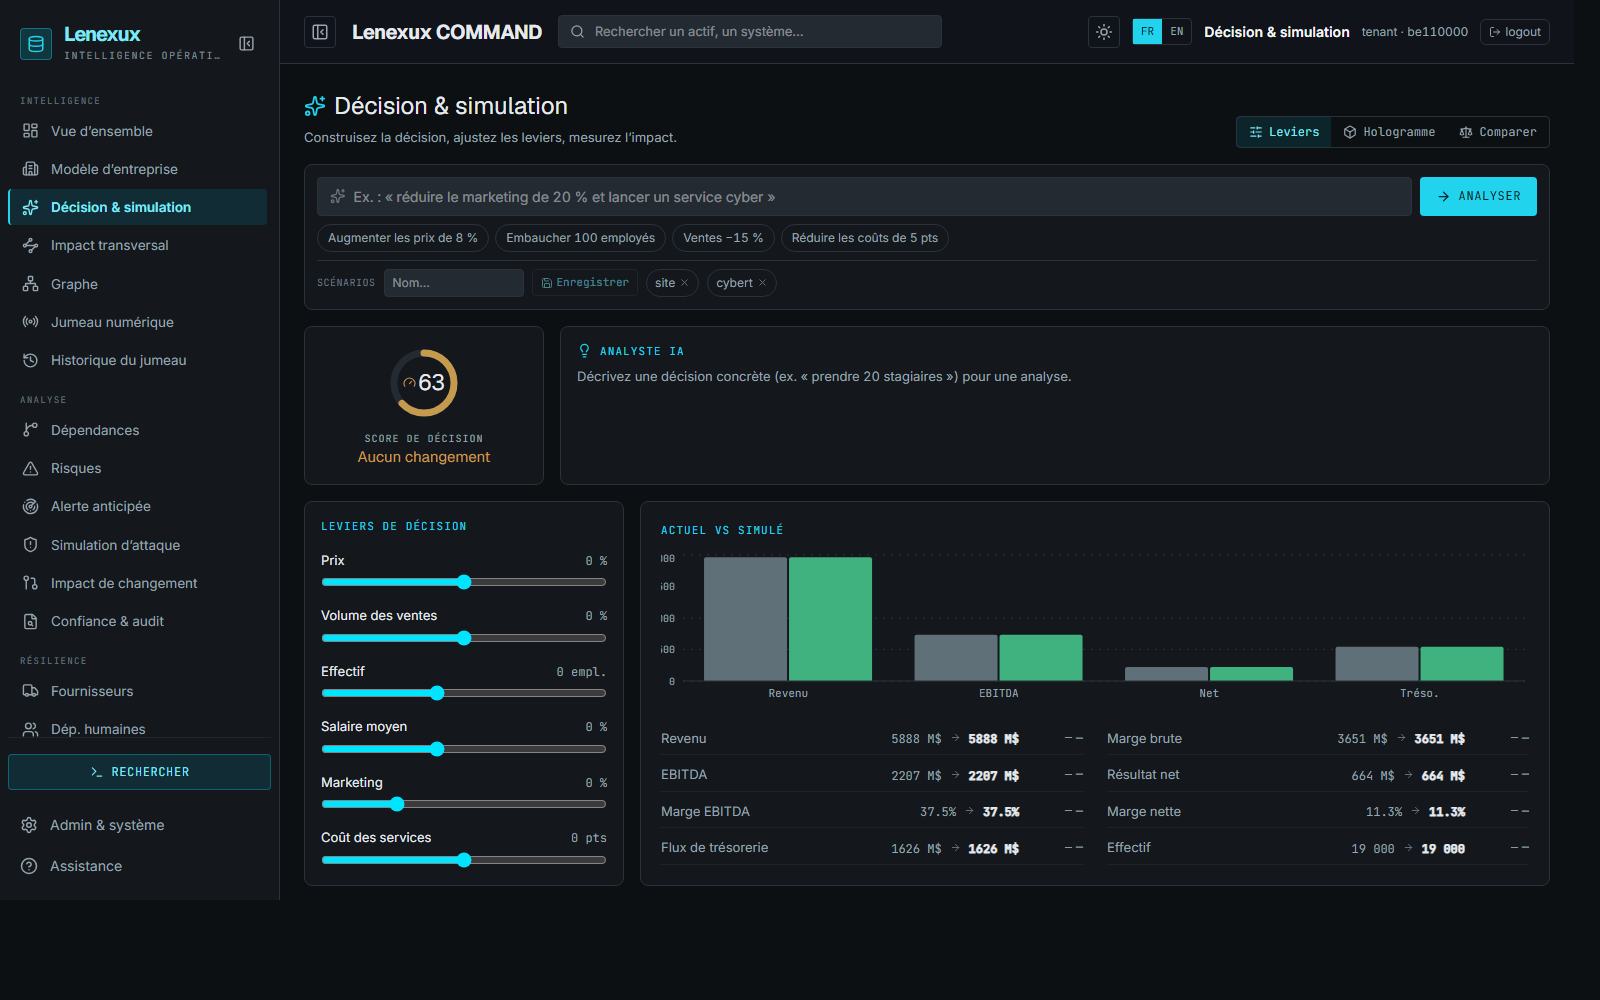
Exprimez une décision en langage naturel (« recruter 50 ingénieurs », « ouvrir un bureau », « campagne marketing »). L’IA la traduit en effets structurés sur les leviers (ou un nouvel élément), et le moteur déterministe calcule l’impact financier — conservateur et explicable.
Jumeau numérique & historique
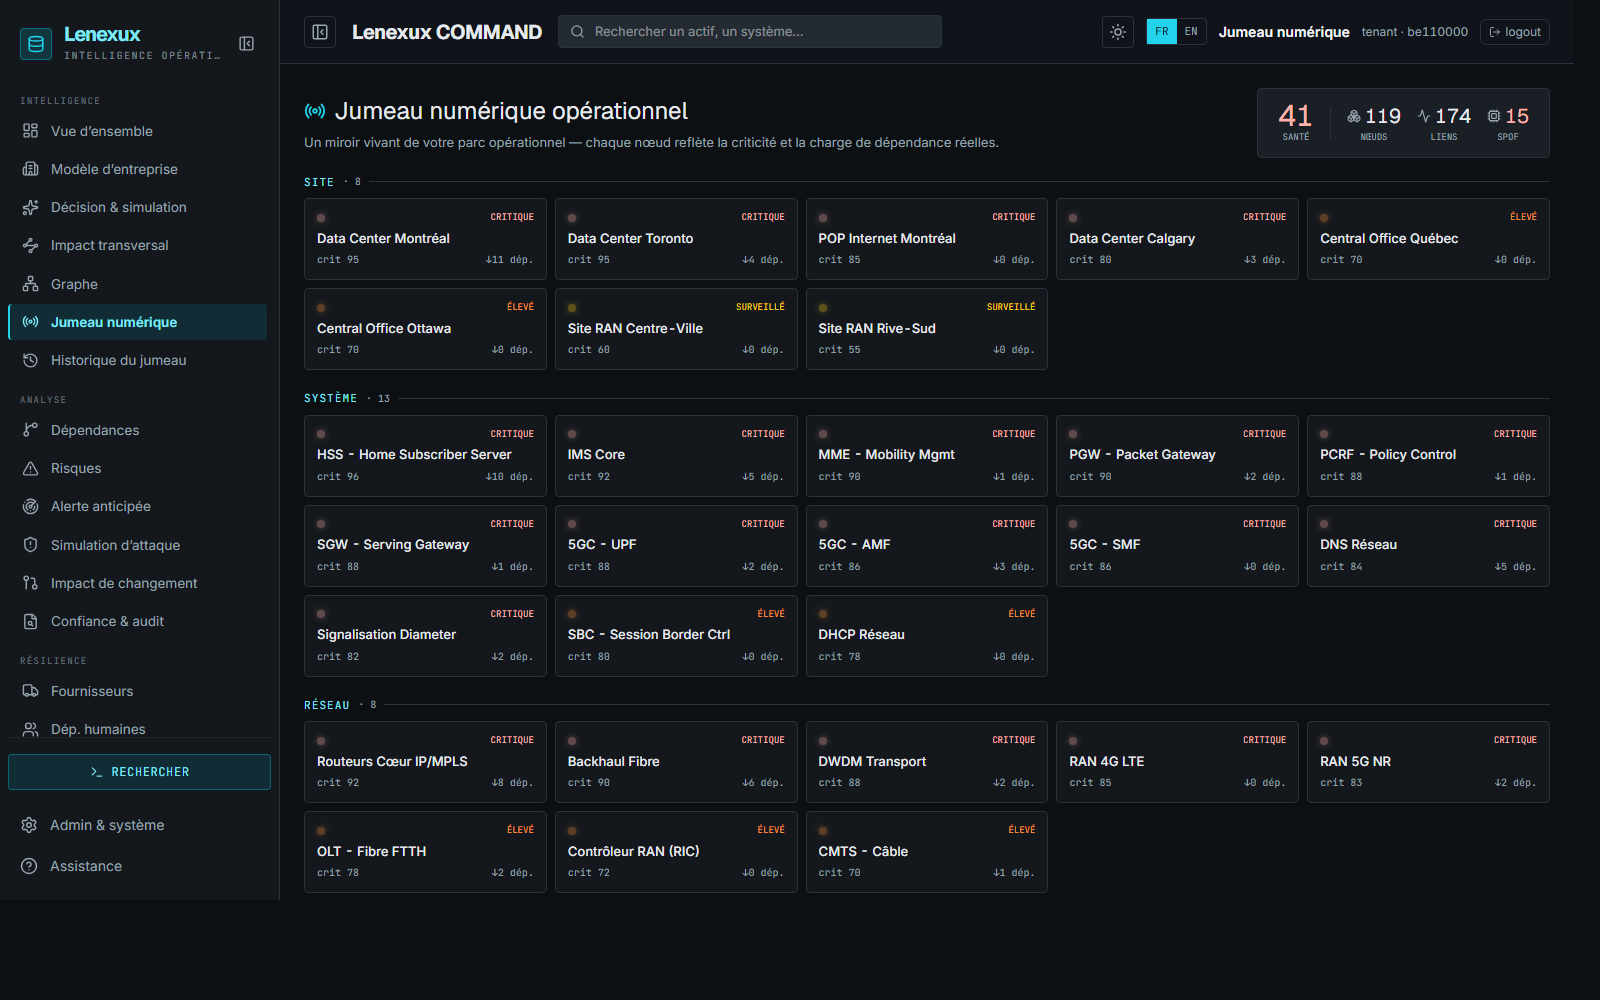
Vue temps réel de l’état opérationnel et de son évolution. L’historique conserve les états successifs pour comparer avant/après un changement.
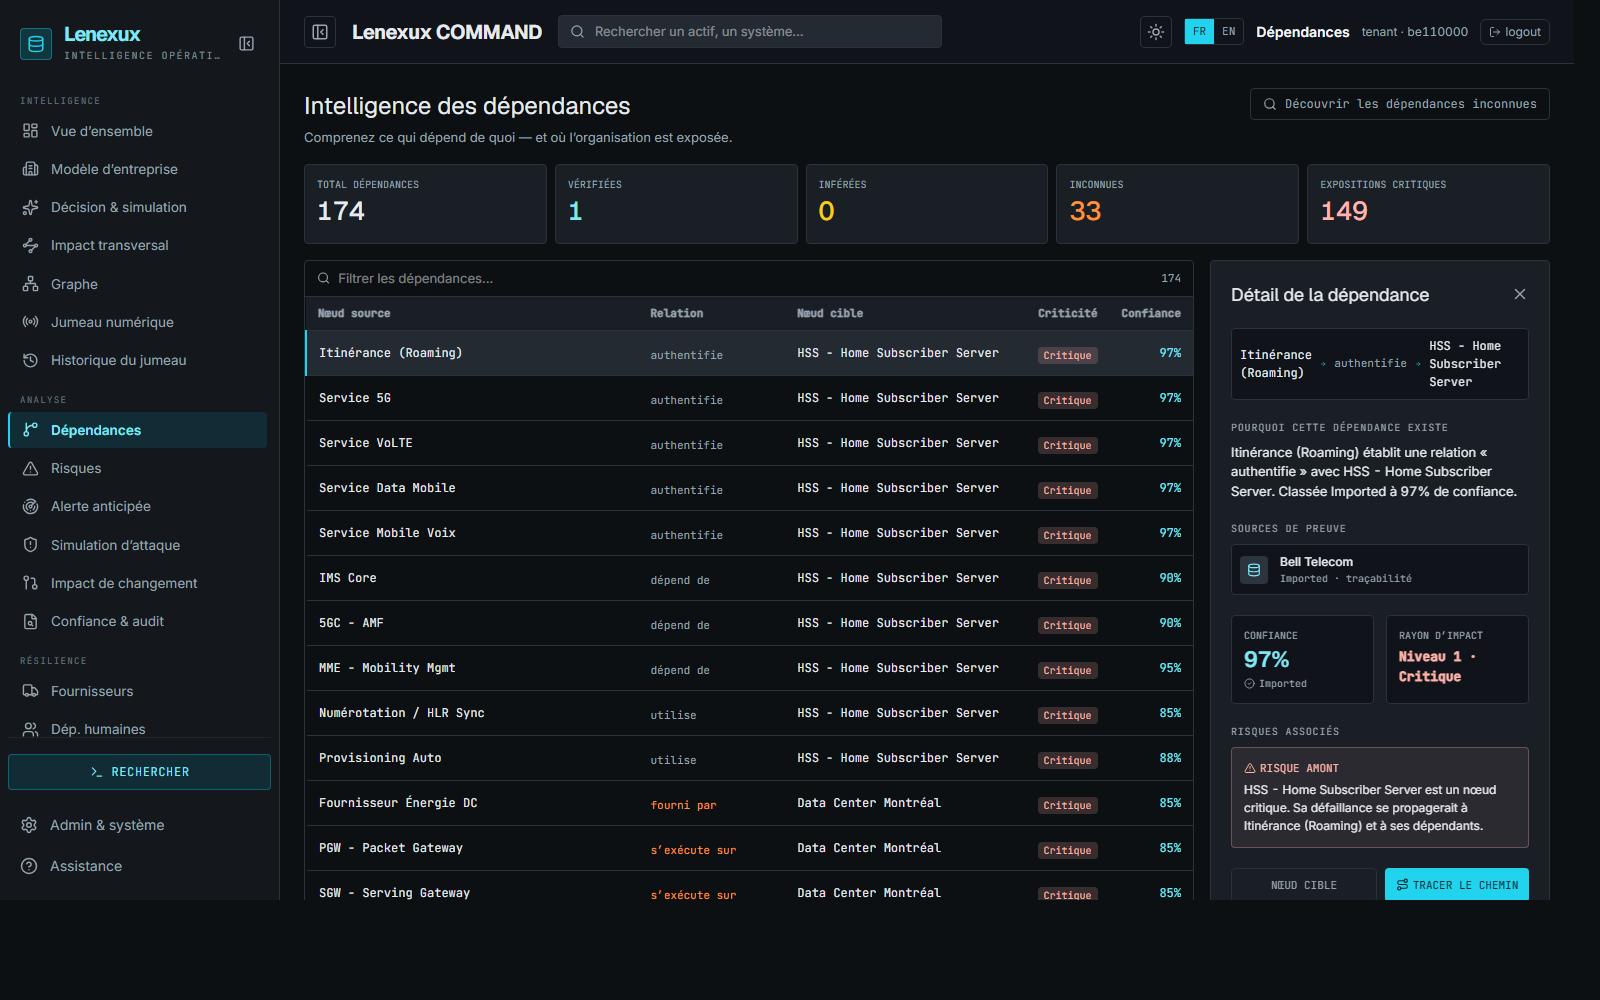
Dépendances
Exploration détaillée des dépendances directes et transitives d’un élément, avec la confiance de chaque relation. Base du moteur de propagation.
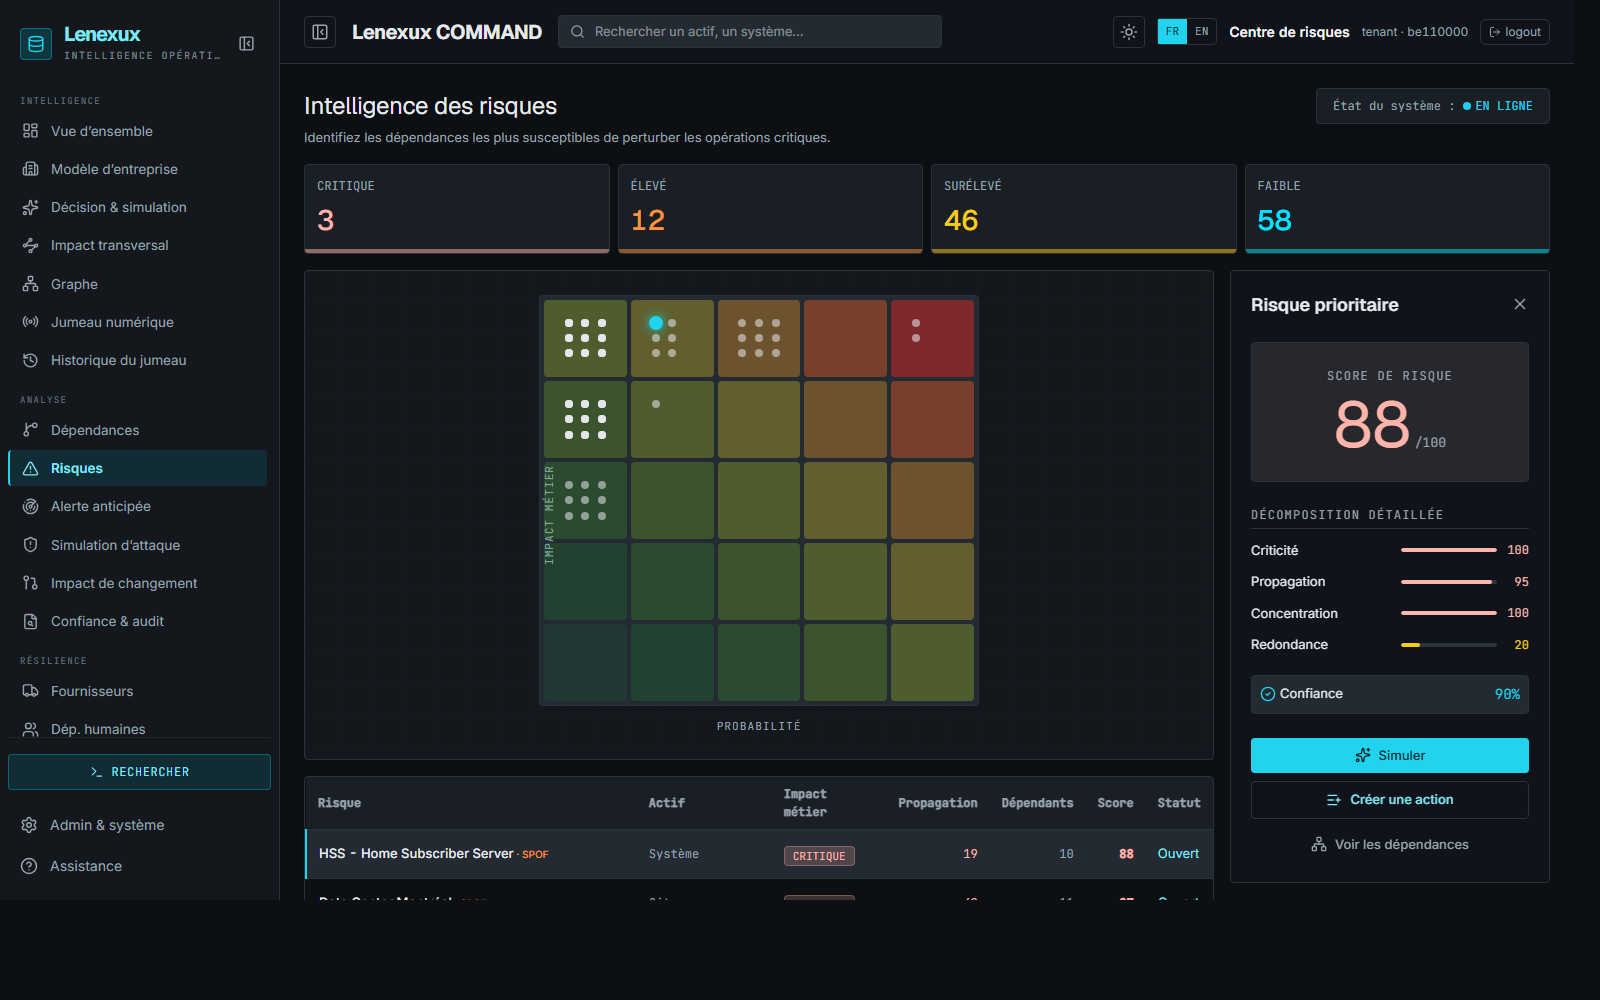
Risques & points uniques de défaillance
Classe les actifs par criticité et met en évidence les SPOF sans redondance dont dépendent de nombreux éléments. Score de risque, exposition financière globale.
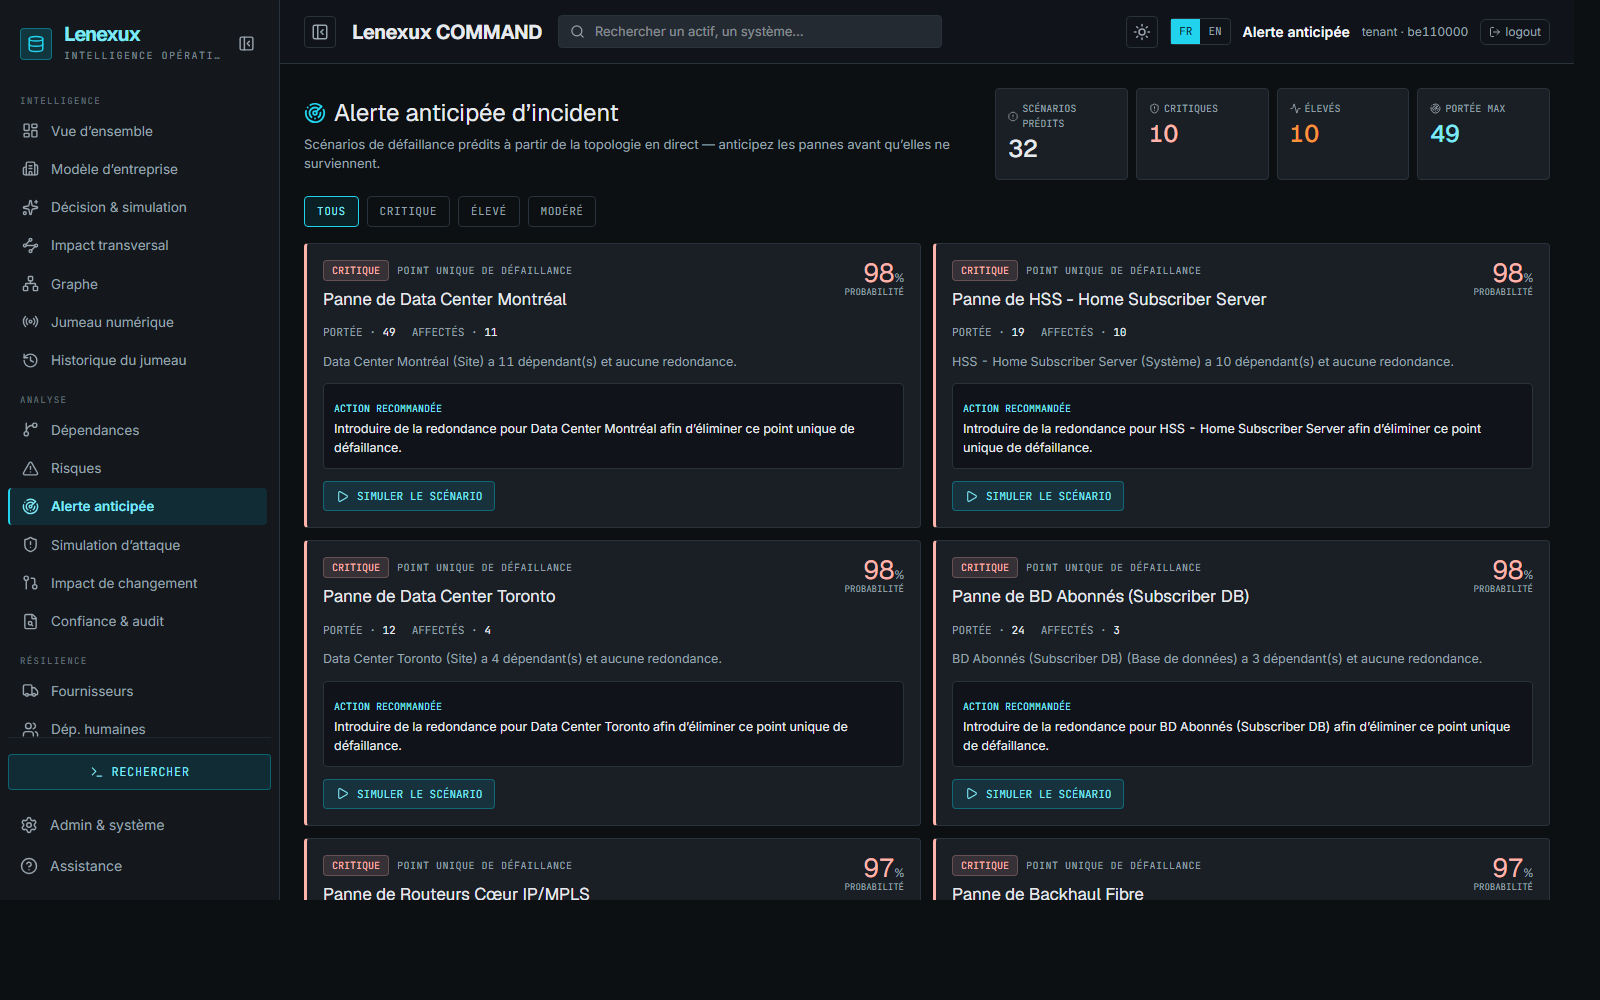
Alerte anticipée
Détecte en amont les configurations à risque (dépendances fragiles, absence de reprise) avant qu’un incident ne survienne.
Impact de changement
Évalue l’impact d’un changement planifié (migration, mise hors service, remplacement) sur les dépendants avant de l’exécuter.
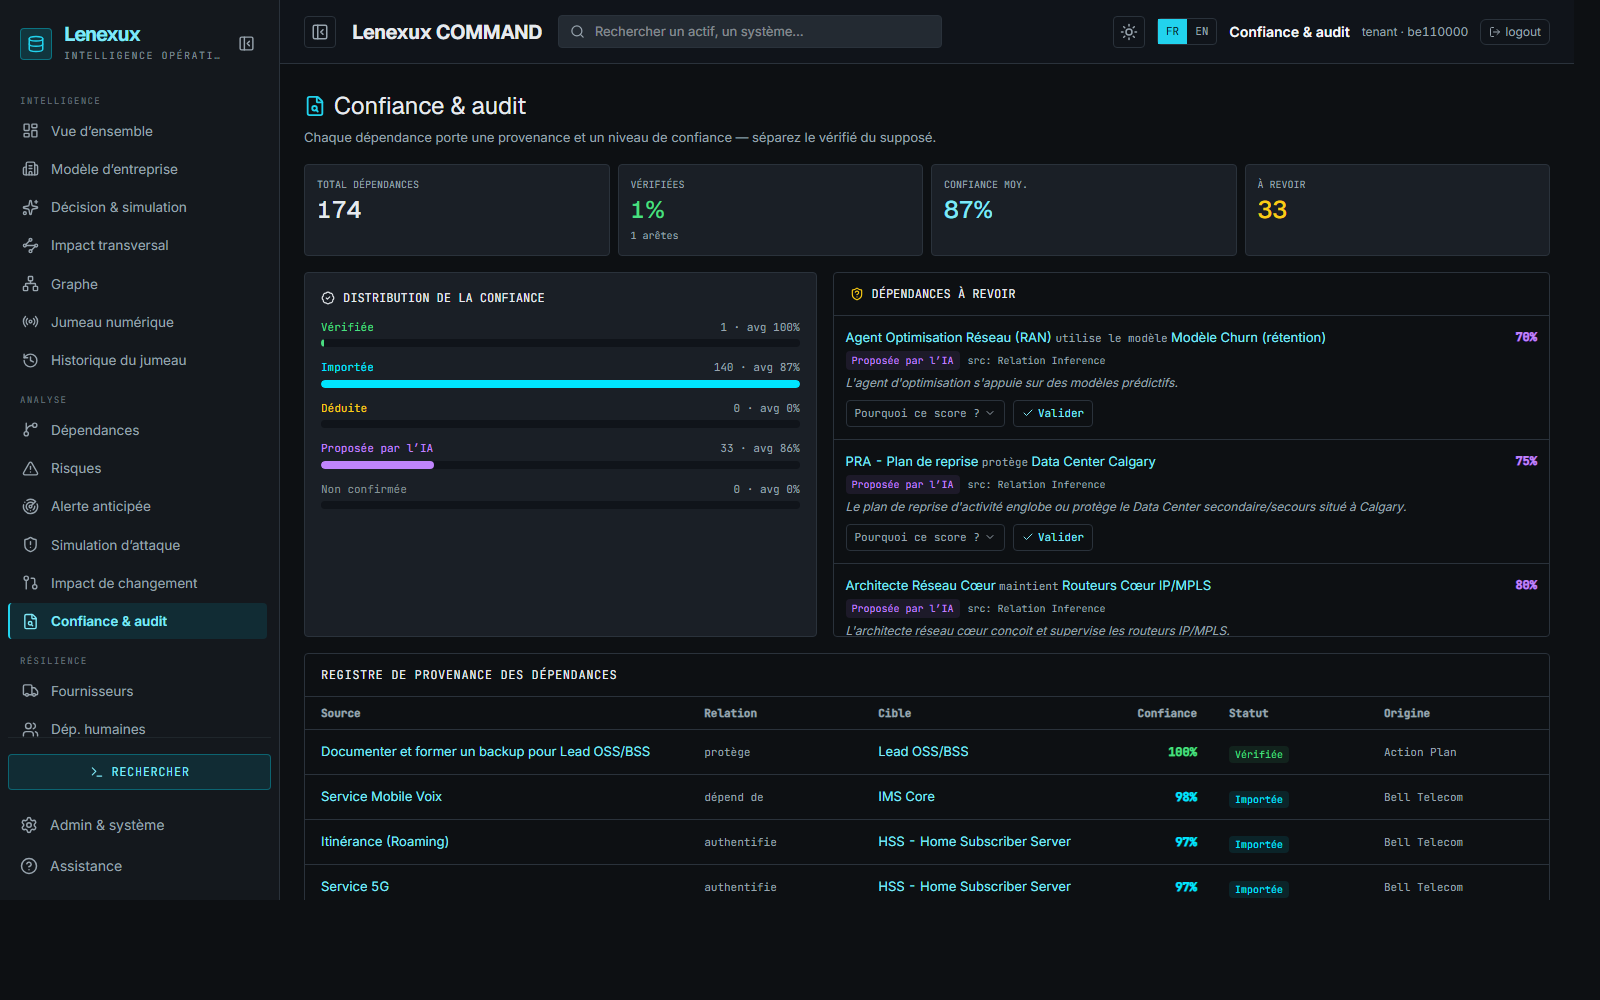
Confiance & audit
Centre de gouvernance de l’ontologie : relations « suggérées par IA » à valider, niveau de confiance, traçabilité (lineage) des données importées.
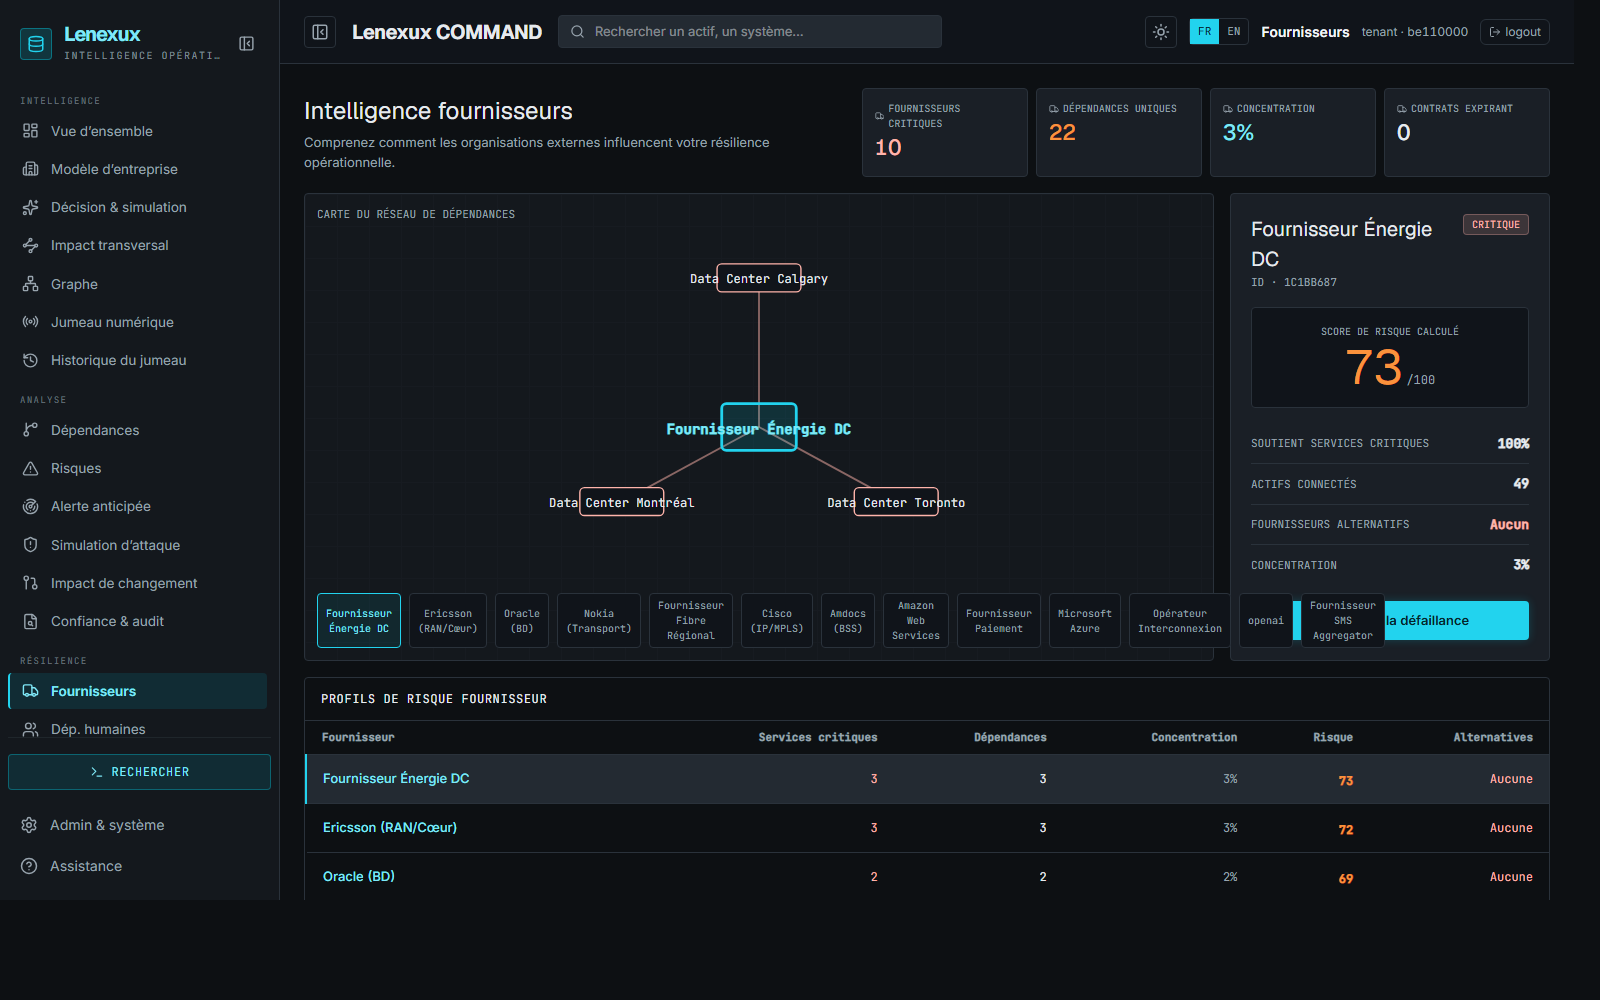
Fournisseurs
Concentration et criticité des fournisseurs, contrats associés et services dépendants — pour anticiper une défaillance externe.
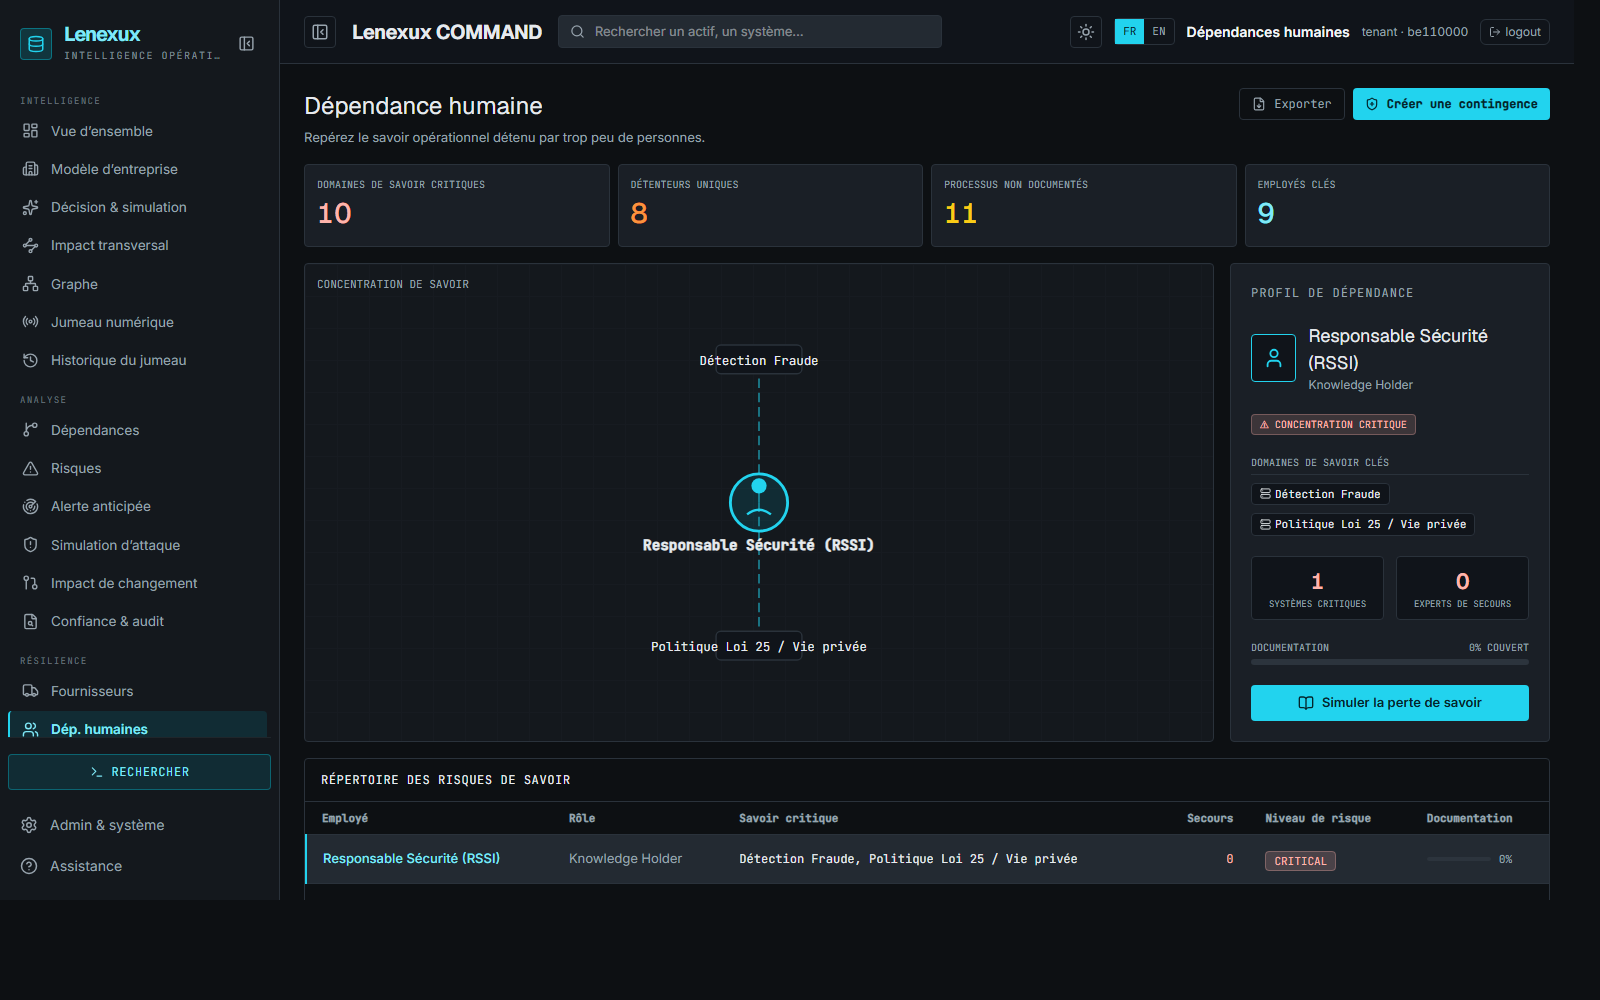
Dépendances humaines
Identifie les personnes clés dont dépendent des processus critiques (risque de « bus factor ») et les points à documenter/déléguer.
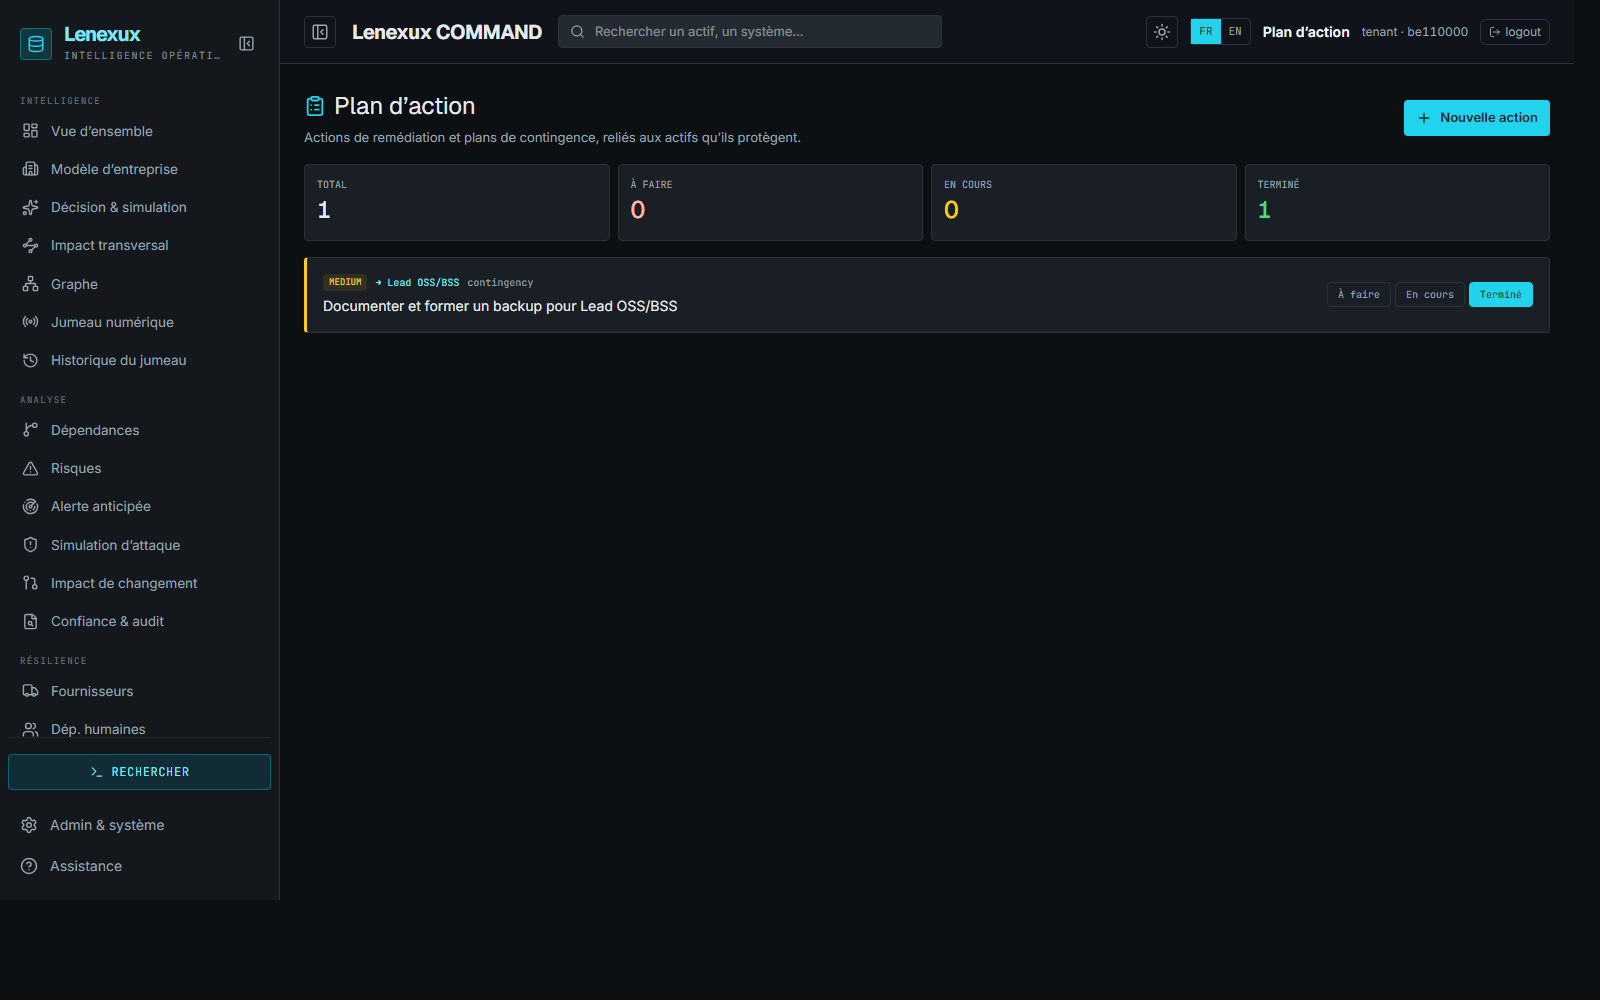
Plan d’action
Consolide les mitigations issues des analyses (redondance, bascule, SLA) en un plan priorisé.
Analyste IA
Interrogez votre organisation en langage naturel. L’IA raisonne sur un contexte structuré issu du graphe et du déterministe ; sans clé IA, l’analyste reste fonctionnel avec des réponses déterministes.
Dépendances inférées (le moat)
Un graphe rempli à la main a peu de valeur. Lenexux lit les entités existantes et propose les dépendances manquantes plausibles (avec justification et confiance) ; vous validez. Rien n’est écrit sans confirmation (statut « suggéré par IA »).
Documents (extraction)
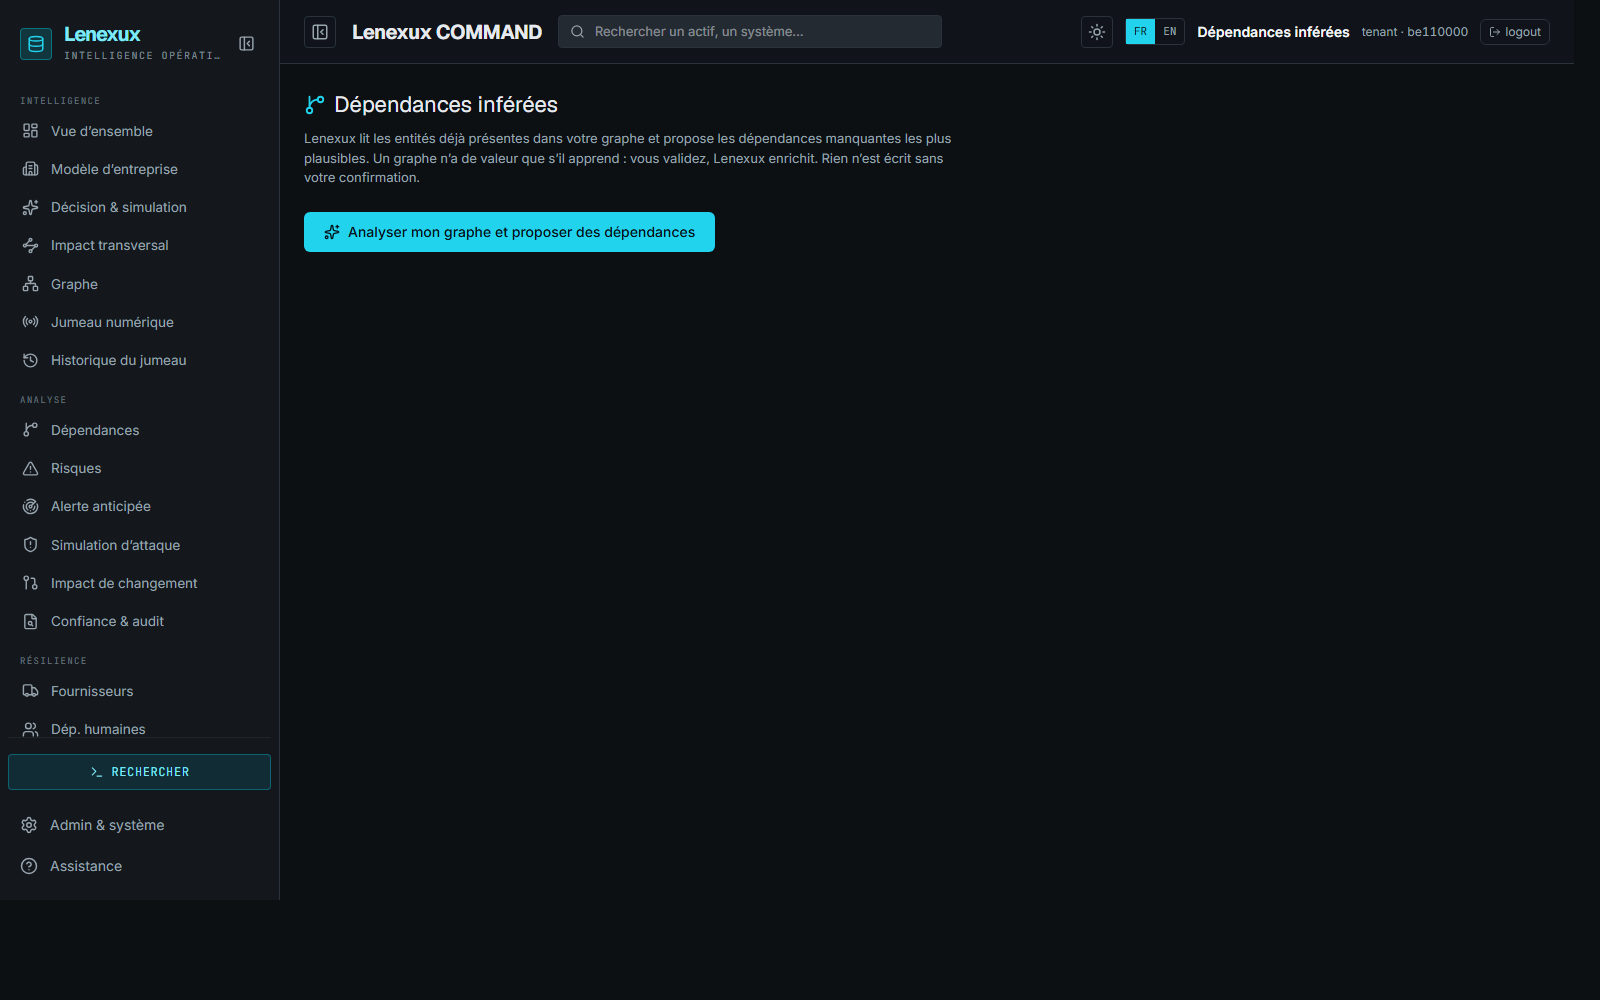
Importez un document Word (.docx), un classeur Excel (.xlsx), un PDF, un CSV ou du texte, ou collez-le. Les tableaux et les feuilles sont lus ligne par ligne, chaque ligne devenant une phrase complète. Les lignes structurées (identifiant et nom, ou source, relation et cible) sont lues exactement, sans IA : un classeur de centaines d’éléments et de liens est repris en entier, identique d’une analyse à l’autre, sans consommer de quota. Le document est découpé en sections : l’IA relève d’abord les éléments et les risques de chaque section, puis cherche les liens en connaissant tous les éléments du document, pour relier une phrase d’une section à un élément nommé dans une autre.
Lenexux fusionne ensuite les doublons (casse, accents, alias, nom court et nom complet), recoupe chaque élément avec votre graphe et calcule lui-même les constats : points de concentration sans secours, éléments reposant sur une seule personne, criticités qui divergent de votre graphe. Vous cochez ce qui entre dans le graphe ; un élément déjà présent n’est jamais recréé, un lien déjà connu n’est jamais dupliqué, et les liens ajoutés restent « suggéré par IA » jusqu’à validation. Les images d’un document et les PDF numérisés sans texte ne sont pas lus.
Rapports
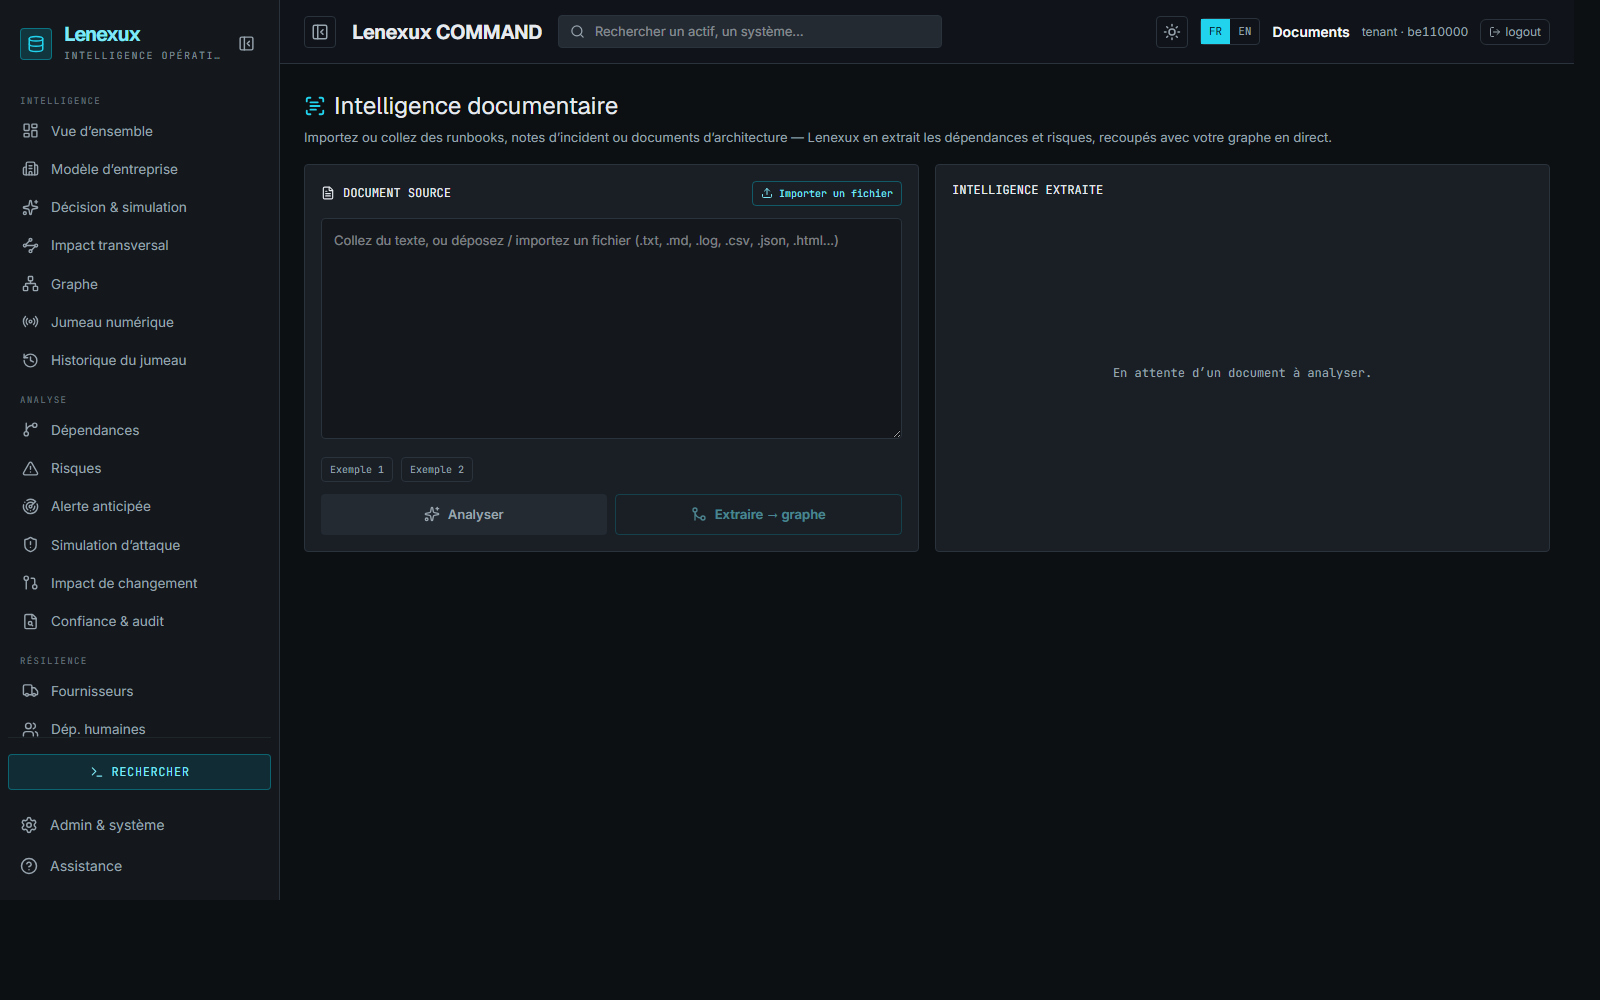
Génère des rapports exécutifs (risques, exposition, points critiques) exportables.
Import & intégration
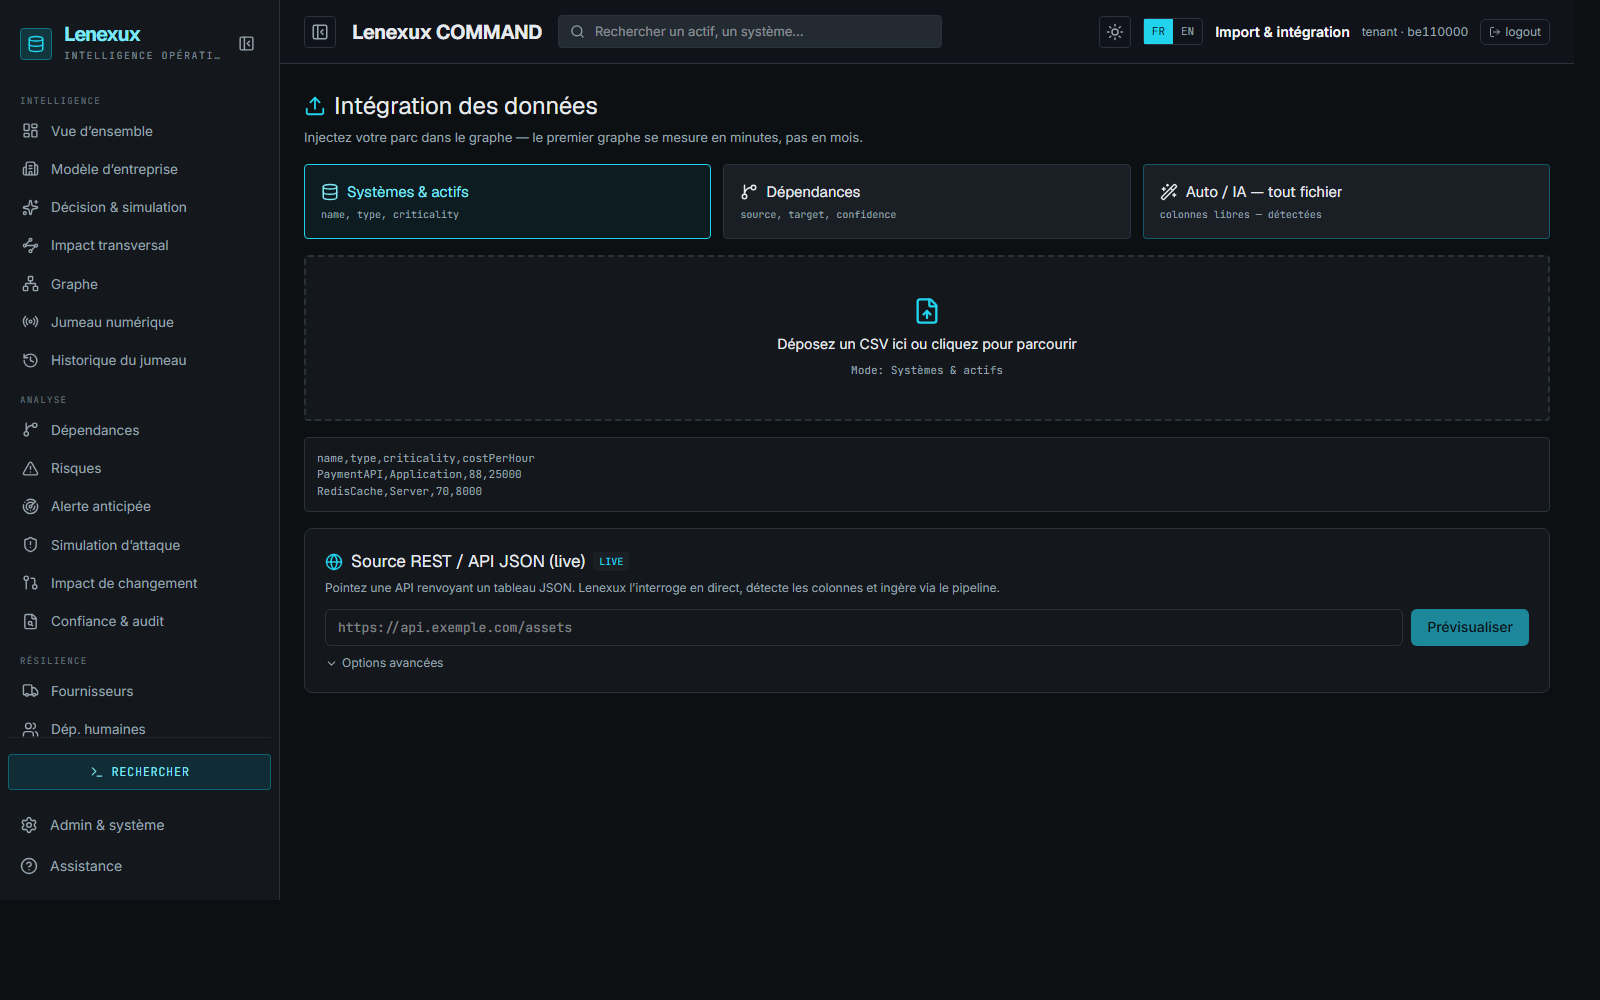
Alimentez le graphe en minutes. Trois modes : Systèmes & actifs (entités), Dépendances (relations), Auto/IA (colonnes libres détectées). Déposez un CSV ou un classeur Excel (.xlsx), ou pointez une API. Pour un classeur, Lenexux liste les feuilles avec leurs colonnes : vous choisissez celle à importer, et ses colonnes sont reconnues quel que soit leur intitulé (« Nom » comme « name »).
Format CSV d’entités (exemple). La colonne costPerHour est optionnelle : c’est le coût d’arrêt réel par heure, qui prime alors sur l’estimation par criticité dans le calcul d’impact.
name,type,criticality,costPerHour
HSS,System,96,50000
BD Abonnés,Database,95,40000
Ericsson,Supplier,88,
Format CSV de relations (source → cible) :
source,sourceType,target,targetType,relation,confidence
Service Mobile Voix,BusinessService,HSS,System,DEPENDS_ON,0.9
Collector, la sonde installée chez vous
Vos systèmes internes ne sont pas exposés sur Internet, et c'est très bien ainsi : Lenexux refuse d'ailleurs délibérément d'atteindre une adresse privée depuis le cloud (garde anti-SSRF). Le Collector lève ce blocage sans affaiblir votre sécurité.
- • Aucun port ouvert, aucune règle de pare-feu entrante : la sonde SORT en HTTPS pour venir chercher son travail. Rien ne peut l’atteindre de l’extérieur.
- • Aucun privilège : conteneur non-root, identifiants en lecture seule que vous choisissez, et uniquement vers les sources que vous désignez.
- • Elle ne fait que COLLECTER. La résolution d’entités, l’ontologie, les preuves et le calcul d’impact restent côté Lenexux, le moteur évolue sans jamais redéployer chez vous.
- • Clé d’authentification stockée en empreinte (jamais en clair), révocable en un clic depuis Admin.
Mise en place — trois étapes :
- • 1. Admin → Collectors → « Déclarer une sonde ». La clé s’affiche UNE seule fois, avec la commande de démarrage prête à copier.
- • 2. Lancez le conteneur sur une VM de votre réseau (Docker, ou l’image de votre choix) avec cette clé.
- • 3. Configurez une collecte : URL interne, en-tête d’authentification éventuel, type de données, et la fréquence de rafraîchissement.
docker run -d --name lenexux-collector --restart unless-stopped \
  -e LENEXUX_CLOUD_URL=https://lenexux.com \
  -e LENEXUX_COLLECTOR_KEY=lxc_… \
  lenexux-collector
Collecte récurrente. Une collecte peut se répéter (ex. toutes les 24 h) : elle se ré-inscrit d'elle-même après chaque exécution. C'est important, car une dépendance qui n'est plus reconfirmée voit sa confiance décoter avec le temps — la cartographie signale ainsi son propre vieillissement.
Ce que la sonde sait interroger aujourd'hui : toute API JSON interne (CMDB, Kubernetes, catalogue de services, application maison), avec ou sans en-tête d'authentification. Les données collectées entrent par le même pipeline que n'importe quelle source, et portent une preuve « source interrogée en direct », plus fiable qu'un fichier déclaratif.
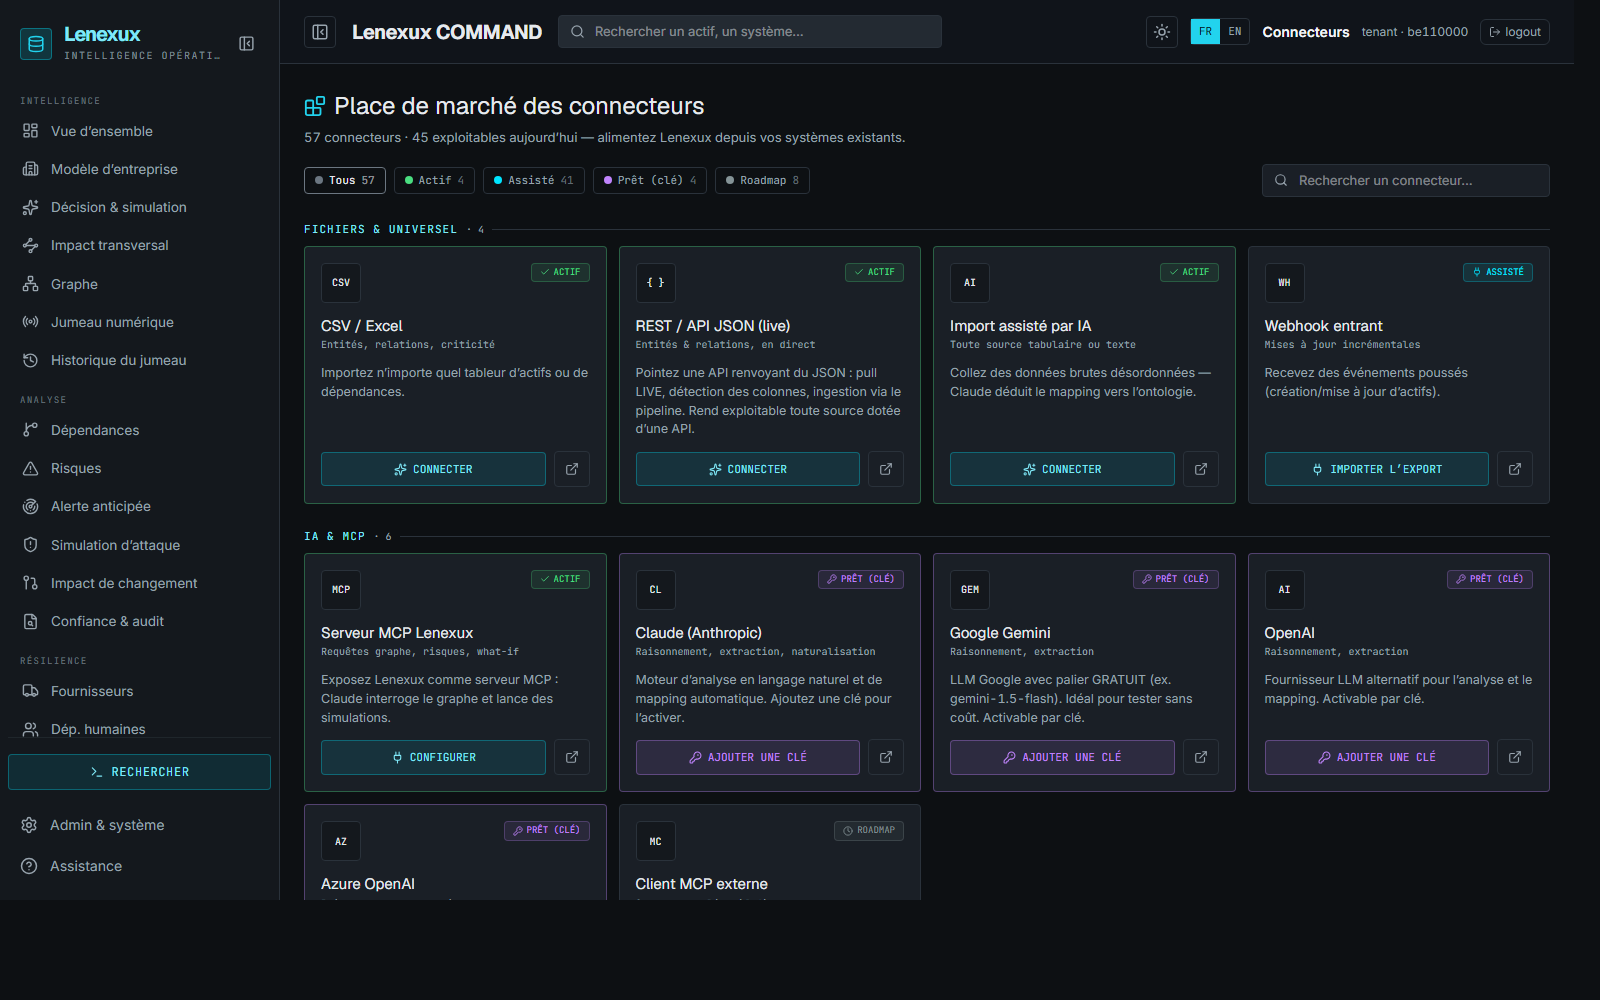
Connecteurs
Dix éditeurs sont interrogés par leur API, puis relus automatiquement : Microsoft Entra ID, Okta, Google Workspace (personnes, postes, responsables, groupes), Microsoft Azure et AWS (ressources, régions, concentration sur un nuage), ServiceNow et Freshservice (éléments de configuration et dépendances déclarées), Datadog et Dynatrace (topologie réellement observée en production), Kubernetes (charges internes, via la sonde).
- • Rafraîchissement automatique : chaque branchement porte sa périodicité et son échéance, conservées en base. Indispensable, puisque la confiance d’une dépendance décote avec le temps.
- • Accès chiffrés (AES-GCM) avec une clé détenue par l’opérateur. Sans cette clé, l’enregistrement est refusé plutôt que dégradé en clair.
- • Lecture partielle signalée : une permission manquante sur une table n’annule pas l’import, mais l’écran le dit, sinon une carte amputée passerait pour complète.
- • CSV / Excel : tout tableur d’actifs ou de dépendances, par l’écran d’import.
- • REST / API JSON (live) : pointez une API renvoyant un tableau JSON, pull en direct, détection des colonnes, ingestion via le pipeline.
- • Import assisté par IA : collez des données brutes, l’IA déduit le mapping vers l’ontologie.
Connecteurs lecture seule par défaut, garde anti-SSRF (refus des adresses internes) et redirections désactivées : une source qui vit dans votre réseau passe par la sonde Collector, jamais par le cloud. La résolution d’entités rapproche automatiquement une même ressource décrite différemment par plusieurs sources (ex. « SQL01 » ≈ « database-server-001 »).
Administration
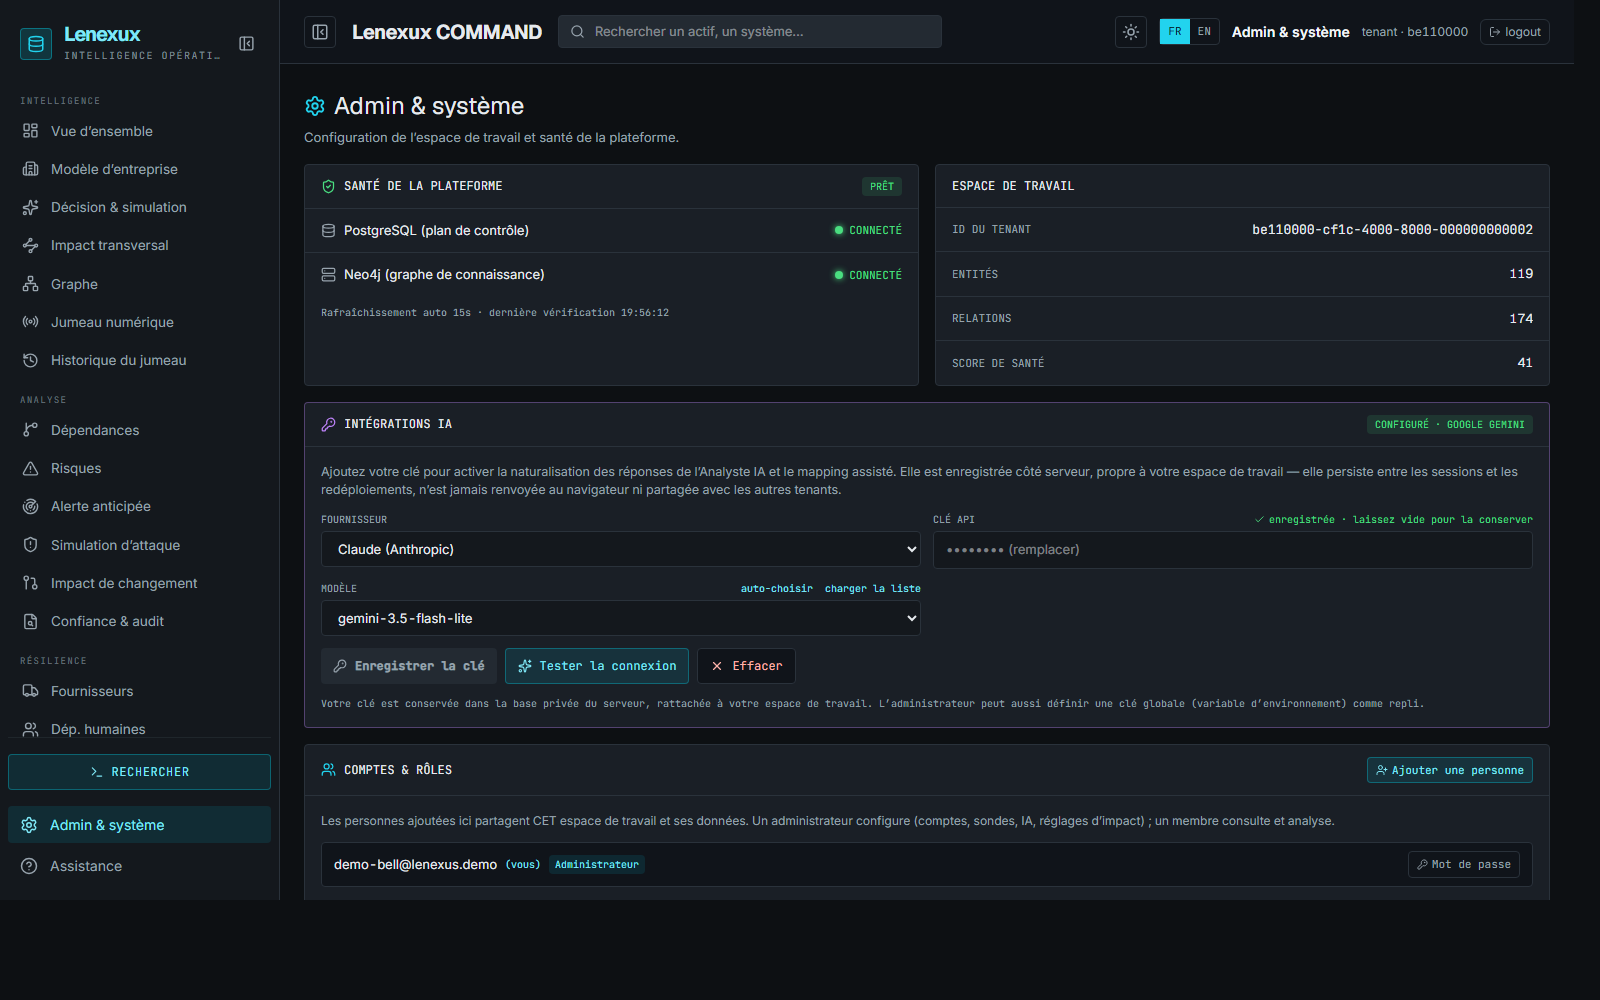
- • Comptes & rôles : plusieurs personnes partagent le MÊME espace de travail. Deux rôles, administrateur (configure : comptes, sondes, IA, réglages d’impact) et membre (consulte et analyse). Un espace conserve toujours au moins un administrateur.
- • Collectors : déclarer, surveiller et révoquer les sondes installées dans votre réseau ; planifier des collectes récurrentes.
- • Configuration IA : l’IA est active dès l’ouverture d’un espace, avec la clé de l’opérateur (OpenRouter, qui bascule seul d’un modèle à l’autre en cas de panne). Une clé propre par tenant reste possible (OpenRouter, Anthropic, Gemini, OpenAI, Azure) ; elle est stockée côté serveur et n’est jamais renvoyée.
- • Quota LLM : le plafond mensuel protège la CLÉ DE L’OPÉRATEUR, par espace et, si la variable est posée, tous espaces confondus. Un espace qui a posé sa propre clé paie ses appels et n’est pas plafonné. Repli déterministe au-delà. Consommation via GET /api/v1/ai/usage.
- • Inscriptions : ouvrables/fermables (NEXUS_ALLOW_REGISTRATION).
Référence API (extrait)
API REST versionnée sous /api/v1. Authentification par jeton JWT (en-tête Authorization: Bearer …). Principaux points d’entrée :
Architecture
- • Backend : .NET 10 (API REST), moteurs déterministes (propagation, risque, impact financier, modèle d’entreprise).
- • Graphe : Neo4j (entités + relations, filtré par tenant).
- • Plan de contrôle : PostgreSQL (comptes, config IA par tenant, usage LLM, modèles, scénarios).
- • Frontend : React + Vite ; graphe 2D (ReactFlow) et 3D (Three.js).
- • IA : fournisseur choisi à l’exécution par tenant ; sans clé, tout reste déterministe.
Déploiement
Déploiement en un clic sur Render via le blueprint render.yaml : web statique (SPA) + API (Docker) + PostgreSQL managé + Neo4j privé, HTTPS automatique. Secrets à définir : NEXUS_JWT_KEY, NEXUS_ADMIN_PASSWORD, mot de passe Neo4j, clé IA. En production, l’API refuse de démarrer sans les secrets obligatoires.
Sécurité
Isolation multi-tenant (requêtes filtrées par tenant, header-tenant interdit en production), authentification requise par défaut, mots de passe PBKDF2 salés, requêtes SQL/Cypher paramétrées, en-têtes de sécurité (HSTS, nosniff, DENY), garde anti-SSRF sur les connecteurs, rate limiting, refus de démarrer en production sans secrets. Détails dans SECURITY.md. Un pentest indépendant est prévu avant la mise en marché générale.
Exploitation (backups, DR, supervision)
- • Sauvegardes : PostgreSQL (plan managé) + procédure de dump Neo4j (OPERATIONS.md).
- • Reprise (DR) : ordre de rétablissement documenté, RPO/RTO cibles.
- • Supervision : /health (liveness) et /health/ready (Postgres + Neo4j), traces/métriques OpenTelemetry.
- • Coûts IA : quota LLM mensuel par tenant, repli déterministe au-delà du plafond.